แยก conda env ให้โมเดลใหม่บน RTX 50 โดยไม่ทำ env เดิมพัง
ของที่รันอยู่ไม่ควรถูกแตะเพียงเพราะเราอยากลองของใหม่ วิธีที่ถูกคือสร้างที่อยู่ใหม่ให้ของใหม่ แล้วพิสูจน์ที่อยู่นั้นด้วยคำสั่งที่อ่านอย่างเดียวก่อนติดตั้งอะไรลงไป
สรุปใน 1 นาที
- อาการ/ปัญหา
- ลงโมเดล image-to-3D บนเครื่อง GPU RTX 50 ที่ไม่มี nvcc ไม่มี MSVC และมีบริการอื่นรันอยู่
- ใครควรอ่าน
- คนที่อยากลองโมเดล AI ใหม่บนเครื่องที่มีงานอื่นรันค้าง
- ทางแก้แบบสั้น
- สร้าง conda env แยกแล้วใช้ wheel สำเร็จรูปแทนการ build CUDA เอง ได้เวลา 190 และ 317 วินาที ภายใต้ VRAM 16 GB
พอดีผมอยากลองโมเดล image-to-3D แบบเปิดตัวหนึ่ง แปลงภาพวัตถุเป็นไฟล์ 3 มิติบนเครื่อง GPU แยกอีกเครื่อง ปัญหาคือเครื่องนั้นมีบริการสร้างภาพของงานอื่นรันค้างอยู่ที่พอร์ต 8080 อยู่แล้ว และการ์ดเป็น RTX 50 รุ่น 16 GB ที่เป็นสถาปัตยกรรม Blackwell (compute capability 12.0 หรือ sm_120) บน Windows ผมเลยต้องหาทางลงของใหม่โดยไม่ทำให้ของเดิมพัง บทความนี้เล่าเป็นวิธีคิดและลำดับขั้นที่ผมใช้ ไม่ใช่สคริปต์ติดตั้งสำเร็จรูป เพราะรายละเอียดคำสั่งของโมเดลนั้นผมไม่ขอยืนยันในที่นี้
ผมไม่ระบุชื่อโมเดล เพราะยังไม่ได้ตรวจเงื่อนไขสัญญาอนุญาต และเลขรุ่นของไลบรารีผมจะเขียนเป็นพารามิเตอร์ ไม่ใช่ค่าตายตัว ตัวเลขที่ผมยืนยันได้มีเฉพาะตัวเลขเวลาและหน่วยความจำที่วัดจากการรันจริง ซึ่งอยู่ในหัวข้อท้าย ๆ
เวลา 190 และ 317 วินาที กับขีด VRAM 15.8 จาก 16 GB มาจากการ์ดและภาพทดสอบของผมเอง ใช้เป็นแนวทางเทียบได้ แต่ไม่ใช่ค่ารับประกันสำหรับเครื่องอื่น และผมไม่ได้เปรียบเทียบคุณภาพระหว่างความละเอียดต่าง ๆ จนสรุปเป็นสูตร
โจทย์: มีของที่รันอยู่ กับโมเดลที่ต้องการของใหม่
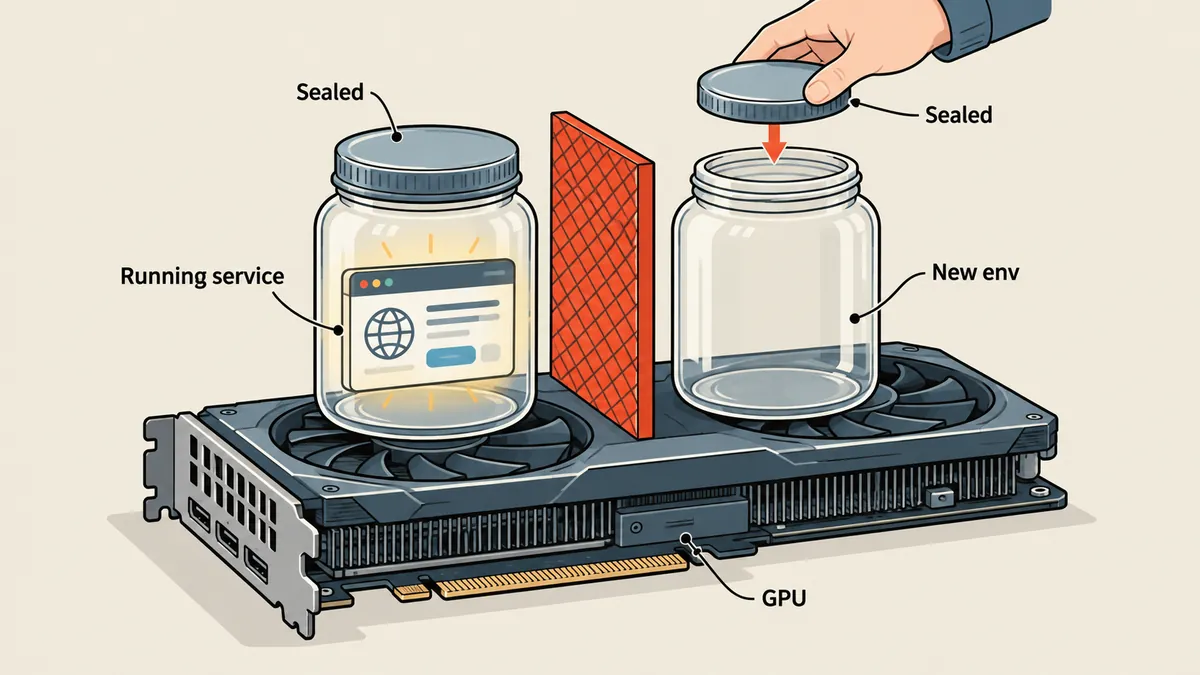
กฎที่ผมยึดคือ ของที่รันอยู่ไม่แตะ ของใหม่ไปอยู่ env ใหม่ เพราะโมเดลวิจัยมักบังคับรุ่นของ PyTorch และส่วนขยาย CUDA ที่ไม่ตรงกับที่ env เดิมใช้ ถ้าติดตั้งทับ env เดิม แล้ว torch ถูกเปลี่ยนรุ่น บริการเดิมที่รันดีอยู่จะพังโดยไม่มีใครเตือน ต้นทุนของการสร้าง env ใหม่คือพื้นที่ดิสก์กับเวลาดาวน์โหลด ซึ่งถูกกว่าการนั่งกู้ env เดิมมาก
เหตุที่ต้องพึ่ง wheel สำเร็จรูปคือเครื่องนี้ไม่มี CUDA toolkit (ไม่มี nvcc) ไม่มี MSVC และไม่มี WSL ส่วนขยาย CUDA ที่โมเดลต้องใช้ build เองจากซอร์สไม่ได้ ต้องหา wheel ที่มีคนใน community build ไว้แล้วสำหรับ Windows บน Blackwell ซึ่ง wheel พวกนี้ผูกกับรุ่นของ Python รุ่นของ torch และรุ่นของ CUDA แบบตายตัว ตรงนี้เองที่ทำให้ต้องมี env แยก เพราะรุ่นที่ wheel ต้องการอาจไม่ใช่รุ่นที่ env เดิมใช้
ตรวจเครื่องก่อนด้วยคำสั่งที่อ่านอย่างเดียว
ก่อนสร้างอะไร ผมรันชุดตรวจชุดเดียวที่ไม่เขียนอะไรลงเครื่อง เพื่อดูว่ามีอะไรอยู่บ้าง ผลที่ผมต้องการรู้มีสามข้อ ข้อแรกมี toolchain สำหรับ build หรือเปล่า ข้อสอง env เดิมมองเห็น GPU ด้วย compute capability เท่าไร และข้อสามบริการเดิมรันอยู่จริงที่พอร์ตไหน
# ตรวจ toolchain สำหรับ build ส่วนขยาย CUDA (อ่านอย่างเดียว)
Get-Command nvcc -ErrorAction SilentlyContinue
Get-Command cl.exe -ErrorAction SilentlyContinue
wsl --status 2>&1 | Select-Object -First 3

# บริการเดิมฟังพอร์ตไหนอยู่
Get-NetTCPConnection -LocalPort 8080 -State Listen -ErrorAction SilentlyContinue |
    Select-Object LocalAddress, LocalPort, OwningProcess
# รันใน env เดิม เพื่อดูว่า GPU ถูกมองเห็นเป็นอะไร (ไม่ติดตั้งอะไรเพิ่ม)
import torch
print("torch        :", torch.__version__)
print("cuda build   :", torch.version.cuda)
print("gpu visible  :", torch.cuda.is_available())
print("capability   :", torch.cuda.get_device_capability(0))   # Blackwell ต้องได้ (12, 0)
print("arch list    :", torch.cuda.get_arch_list())
ในเครื่องของผม ผลคือไม่พบ nvcc ไม่พบ MSVC และไม่มี WSL ส่วน env เดิมมองเห็น GPU ได้ตามปกติ เลขรุ่นของ torch ใน env เดิมกับรุ่นที่ wheel สำเร็จรูปต้องการเป็นคนละรุ่นกัน ผมจดไว้จากบันทึกการทำงาน แต่ไม่ขอระบุเลขที่นี่ เพราะมันต้องตรวจซ้ำกับ wheel ที่ใช้อยู่จริงทุกครั้ง ที่ต้องจำคือให้ดูบรรทัด arch list ว่ามี sm_120 อยู่ในรายการ ถ้าไม่มี แปลว่า build ของ torch ตัวนั้นไม่รองรับการ์ด Blackwell ซึ่งเป็นเรื่องเดียวกับที่ผมเคยเจอฝั่ง TensorFlow ใน บทความเรื่อง RTX 50 กับ DirectML
สร้าง env ใหม่ แล้วพิสูจน์ GPU ก่อนลงโมเดล
ลำดับที่ผมใช้ให้พิสูจน์ทีละชั้น ชั้นล่างต้องผ่านก่อนถึงจะไปชั้นบนได้ ไม่งั้นเวลาพังจะไม่รู้ว่าพังที่ชั้นไหน
- สร้าง env ชื่อใหม่ที่ไม่ซ้ำกับของเดิม และเลือก Python รุ่นที่ wheel สำเร็จรูประบุ
- ติดตั้ง torch รุ่นที่ wheel ต้องการ จาก index ของ CUDA ที่ตรงกัน (ในกรณีนี้เป็นสาย cu130)
- รัน
get_device_capability()ต้องได้ (12, 0) และทดลองคูณเมทริกซ์บน GPU หนึ่งครั้ง - ติดตั้ง wheel ของส่วนขยาย CUDA ที่ตรงกับ Python torch และ CUDA ของ env นี้
- ติดตั้งตัวโมเดลและ dependency ที่เหลือ แล้วดาวน์โหลดน้ำหนักโมเดลกับโมเดลฐานที่มันเรียกใช้แยกออกมาเป็นขั้นต่างหาก
# ตัวอย่างโครง ไม่ใช่สคริปต์จริง: แทนค่าให้ตรงกับที่ wheel สำเร็จรูประบุ
conda create -n image3d python=3.12 -y
conda activate image3d
pip install torch==<รุ่นที่ wheel รองรับ> --index-url https://download.pytorch.org/whl/cu130

python -c "import torch; print(torch.cuda.get_device_capability(0))"   # ต้องได้ (12, 0)
python -c "import torch; x=torch.randn(2048,2048,device='cuda'); print((x@x).sum().item())"

pip install <ไฟล์ wheel ของส่วนขยาย CUDA ที่ตรง Python/torch/CUDA>
ผมใส่ <รุ่นที่ wheel รองรับ> ไว้ตั้งใจ เพราะรุ่นที่ถูกต้องคือรุ่นที่ wheel สำเร็จรูปของส่วนขยายนั้นประกาศไว้ ไม่ใช่รุ่นล่าสุดของ torch ถ้าเอารุ่นล่าสุดมาแล้ว wheel ไม่ตรง จะได้ error ตอน import หรือแย่กว่านั้นคือรันได้แต่ผลเพี้ยน ผมไม่ขอเขียนชื่อไฟล์ wheel ที่ใช้จริง เพราะชื่อเต็มผมยังไม่ได้ยืนยัน
ติดตั้งเป็นงานเบื้องหลัง แล้วดูจาก log
การติดตั้งโมเดลวิจัยกินเวลา ดาวน์โหลดน้ำหนักโมเดลกับโมเดลฐานใช้เวลาหลายสิบนาทีขึ้นไป ผมไม่ได้แยกเวลาดาวน์โหลดกับเวลาติดตั้งออกจากกัน เลยไม่มีตัวเลขเฉพาะให้ ผมเลยรันเป็นงานเบื้องหลังที่เขียน log ลงไฟล์ แล้วไล่ดูท้ายไฟล์เป็นระยะ ไม่นั่งรอหน้าจอ และถ้าคอนโซลหลุดงานก็ไม่ตาย
# รันติดตั้งเป็นงานเบื้องหลัง เขียน log แยก stdout / stderr
$job = Start-Process -FilePath "pwsh" `
    -ArgumentList "-NoProfile","-File",".\install-model.ps1" `
    -RedirectStandardOutput ".\install.out.log" `
    -RedirectStandardError  ".\install.err.log" `
    -PassThru -WindowStyle Hidden
$job.Id

# ดูความคืบหน้าจากท้าย log
Get-Content .\install.out.log -Tail 20 -Wait
ก่อนรีบูตเครื่อง ผมหยุดงานนี้ไว้ตามคำสั่งเจ้าของเครื่อง แล้วค่อยทำต่อหลังรีบูตเสร็จ ข้อนี้ย้ำว่าถ้าเครื่องมีบริการของคนอื่นรันอยู่ จังหวะที่จะรีบูตหรือกินทรัพยากรหนัก ๆ ต้องเป็นเรื่องที่ตกลงกันก่อน
รันรอบแรกล้มหลายรอบ และนั่นคือเรื่องปกติ
เมื่อติดตั้งครบและรัน inference ภาพเดียวครั้งแรก มันล้มหลายรอบ ทุกรอบเป็นปัญหาเล็ก ๆ ที่ต้องแก้ทีละจุด
- ตัวลบพื้นหลังรุ่นที่โค้ดเรียกใช้ใช้ไม่ได้ ผมเปลี่ยนไปใช้โมเดลลบพื้นหลังแบบเปิดอีกตัวแทน
- ขาดแพ็กเกจ einops ต้อง
pip install einopsเพิ่มเอง เพราะ dependency ไม่ได้ประกาศไว้ครบ - import ของขั้น postprocess ผิด รอบหนึ่งโปรแกรมออกด้วย exit code 2 ต้องแก้บรรทัด import ให้ตรงกับโมดูลที่มีอยู่จริง
แก้ครบแล้วรันผ่าน ข้อที่ผมอยากเตือนคนที่จะลองคือ ติดตั้งโมเดลวิจัยบน Windows ให้คาดไว้ก่อนเลยว่าจะต้องแก้ dependency ทีละจุด โค้ดวิจัยส่วนใหญ่เขียนและทดสอบบน Linux ที่มี toolchain ครบ พอมาอยู่บน Windows ที่ไม่มี compiler รอยต่อเล็ก ๆ พวกนี้จะโผล่ออกมาทีละอัน ซึ่งไม่ได้แปลว่าวิธีที่เลือกผิด
ผมให้ทุกรอบเขียน stderr ลงไฟล์แยก แล้วอ่านบรรทัดสุดท้ายของ traceback ก่อนจะเดาอะไร สามข้อข้างบนล้วนบอกสาเหตุตรง ๆ ในบรรทัดท้ายของ traceback ทั้งนั้น ถ้าไม่เก็บ log การไล่หาจะกินเวลามากกว่าตัวแก้เองหลายเท่า
ผลที่วัดได้: ภาพเดียวกับหลายมุม และเพดาน VRAM
ผมรันในโหมดประหยัด VRAM บนการ์ด 16 GB สองแบบ แบบแรกใช้ภาพเดียว แบบที่สองใช้ภาพสี่มุม ผลที่วัดได้
ไฟล์ GLB ที่ได้ใหญ่ราว 39 MB และมีราวหนึ่งล้านหน้าสามเหลี่ยม ทั้งสองแบบ ส่วนที่ต่างกันคือคุณภาพของด้านที่กล้องมองไม่เห็น แบบภาพเดียวระบบต้อง เดา ด้านหลังและด้านข้าง ส่วนแบบสี่มุมให้ด้านหลังกับด้านข้างตรงกับภาพจริงมากกว่า เพราะมีข้อมูลจริงให้เกาะ
ความละเอียด 1536 สำหรับชิ้นส่วนเล็กใช้ VRAM 15.8 จาก 16 GB ติดอยู่ที่ขั้นสร้าง mesh และช้ากว่าปกติมาก ผมเลยตั้งใจถอยไปที่ 1024 ถ้าผลไม่ต่างกันชัดเจน แต่ผมยังไม่ได้เปรียบเทียบผลของสองความละเอียดนี้ เลยไม่ขอบอกว่าต่างหรือไม่ต่าง ใครมีการ์ดเล็กกว่านี้ควรคาดว่าเพดานจะมาถึงเร็วกว่าผม
โหมดหลายมุม ตั้งกล้องให้ตรงกับที่โมเดลคาดหวัง
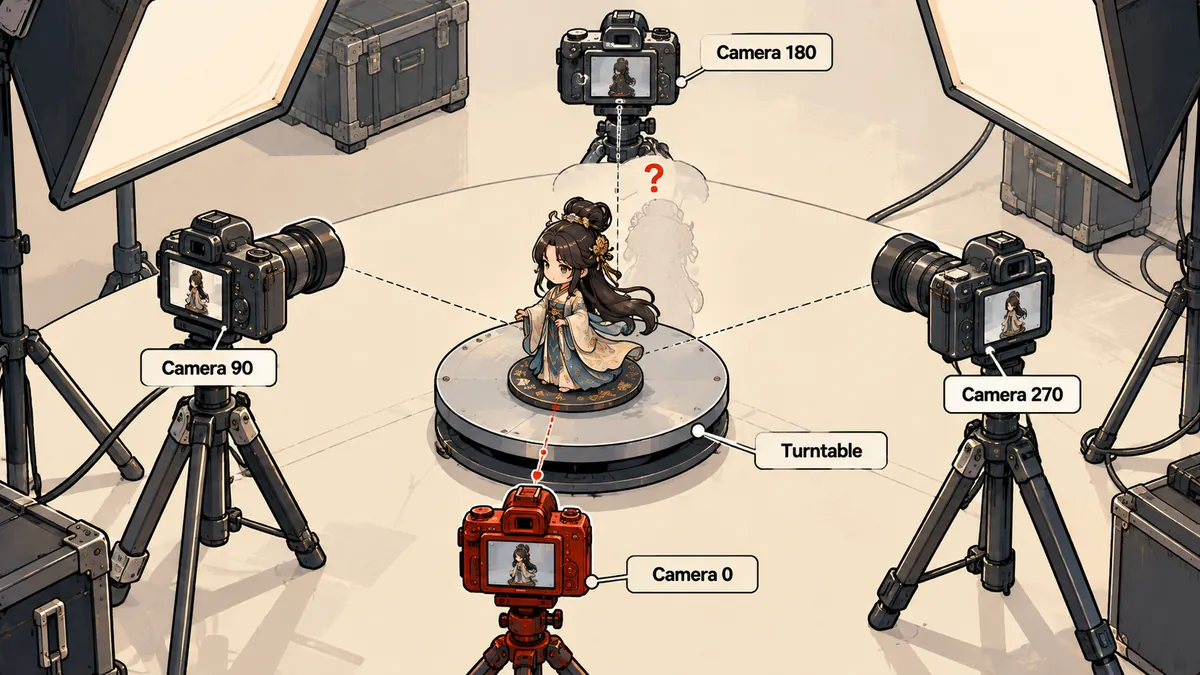
โหมดสี่มุมต้องบอกตำแหน่งกล้องของแต่ละภาพให้โมเดลรู้ มุมที่ผมใช้คือ azimuth 0, 90, 180, 270 องศา เรียงเป็น หน้า ซ้าย หลัง ขวา ด้วย FOV 20 องศา และให้วัตถุกินภาพราว 90% ของเฟรม (เป้าหมายคือ 88%) ตัวอย่างทางการของโมเดลใช้สี่มุมนี้ ถ้าใช้จำนวนมุมหรือตำแหน่งอื่นต้องยอมรับว่าผมไม่ได้ทดสอบ
ส่วนระยะกล้องที่ทำให้วัตถุกินภาพตามเป้า คำนวณได้จากเรขาคณิตง่าย ๆ ผมเขียนฟังก์ชันเล็ก ๆ ไว้ตรวจก่อนถ่ายภาพ เป็นตัวอย่างที่ผมเขียนเองตามหลักการ ไม่ใช่สคริปต์ของโมเดล
import math

def camera_distance(object_radius, fov_deg=20.0, fill=0.90):
    """ระยะกล้องที่ทำให้วัตถุ (ทรงกลมห่อ รัศมี object_radius) กินภาพประมาณ fill"""
    half = math.radians(fov_deg) / 2
    return object_radius / (fill * math.tan(half))

def positions(object_radius, azimuths=(0, 90, 180, 270)):
    d = camera_distance(object_radius)
    return [(a, round(d * math.sin(math.radians(a)), 4),
                round(d * math.cos(math.radians(a)), 4)) for a in azimuths]

print(positions(0.5))   # (มุม, x, z) ของกล้องแต่ละตัวที่มองเข้าหาจุดกลาง
บทเรียนเรื่องภาพอินพุต และการนำผลเข้า Blender
โมเดลลักษณะนี้เรียนจากภาพเรนเดอร์ของวัตถุ 3 มิติ ภาพลายเส้น 2 มิติแบน ๆ เลยทำให้ปริมาตรอ่านไม่ออก และส่วนที่เล็กในภาพจะได้ voxel น้อยจนรายละเอียดหาย วิธีบรรเทาที่ผมวางแผนไว้คือครอปส่วนเล็กให้เต็มภาพแล้วรันแยก กับใช้ภาพที่มีเงาและมีปริมาตร ในรอบที่ลองผมเห็นว่าการรันส่วนเล็กแยกดีขึ้นชัดเจน แต่ยังทดสอบไม่ครบ ผมเลยไม่สรุปเป็นสูตร ใครจะใช้ก็ต้องลองกับภาพของตัวเอง
ส่วนการนำ GLB เข้า Blender เพื่อวางโมเดลจากภาพเดียวกับจากสี่มุมเทียบกันข้าง ๆ ผมสั่งผ่าน MCP ด้วยวิธีสคริปต์หนึ่งไฟล์ต่อหนึ่งการเปลี่ยนฉาก ตามที่เล่าไว้ใน บทความเรื่อง Blender กับ STDIO bridge ซึ่งทำให้การเทียบเป็นขั้นตอนที่ย้อนดูได้
สรุปลำดับที่ผมใช้
ส่วนตัวผมถือว่าบนเครื่องที่มีของรันอยู่แล้ว ต้องแยก env เท่านั้น ไม่ต้องลองติดตั้งทับแล้วหวังว่าจะรอด ลำดับคือ ตรวจเครื่องแบบอ่านอย่างเดียว สร้าง env ใหม่ พิสูจน์ GPU ด้วย get_device_capability() ก่อนลงอะไรเพิ่ม ติดตั้งเป็นงานเบื้องหลังพร้อม log และยอมรับตั้งแต่ต้นว่าต้องแก้ dependency ทีละจุด ส่วนตัวเลขเวลาและ VRAM เอาไว้เทียบกับเครื่องของตัวเองตามสะดวก
สิ่งที่ผมยังไม่ยืนยันและเลยไม่เขียนเป็นข้อเท็จจริง คือเลขรุ่น torch ที่แน่นอนของทั้งสอง env ชื่อไฟล์ wheel เต็ม ๆ และคำสั่งติดตั้งตัวโมเดล ตรงไหนผมอธิบายตกหรือรุ่นของไลบรารีเปลี่ยนไปจนไม่ตรงกับที่เล่า เดี๋ยวกลับมาแก้เพิ่มให้ภายหลังครับ
เคยเจองานแบบนี้ไหม? ติดตรงไหน?
มาแลกวิธีกันต่อในบอร์ด LinuxThai
ความคิดเห็น 0
ยังไม่มีความคิดเห็น — เป็นคนแรกเลย