แพ็กเกจซิงก์ถูกตัดกลางทางล้างข้อมูลจริง: ด่าน held และ dump
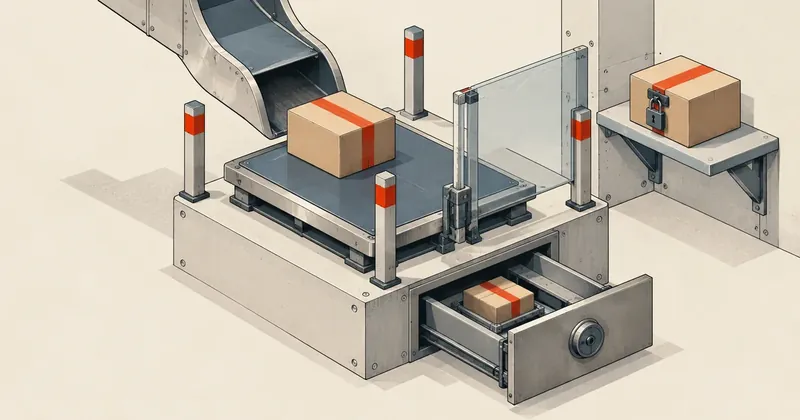
การซิงก์ข้อมูลขึ้นเว็บจริงที่ไม่ต้องมีคนกดทุกรอบคือของดี แต่ถ้ามันเชื่อทุกแพ็กเกจที่ส่งมา วันที่ export ถูกตัดไปครึ่งทางมันจะล้างของจริงตามไปด้วยโดยไม่มีใครรู้
สรุปใน 1 นาที
- อาการ/ปัญหา
- แพ็กเกจซิงก์ที่ export ถูกตัดกลางทาง อาจล้างข้อมูลบนเว็บจริงตามไปด้วย
- ใครควรอ่าน
- คนที่ซิงก์ข้อมูลจากเครื่องตัวเองขึ้นเว็บจริงผ่าน inbox และ cron
- ทางแก้แบบสั้น
- เทียบสัดส่วนกับฐานข้อมูลจริงก่อนนำเข้า ถ้าผิดปกติให้ held พร้อมทางออกชัดเจน และ dump ก่อนนำเข้าทุกครั้ง
พอดีงานของเว็บลูกค้ารายหนึ่งมีข้อมูลต้นทางอยู่บนเครื่องส่วนตัวของผู้ดูแล แล้วต้องส่งส่วนที่เปลี่ยนขึ้นเว็บจริงเป็นระยะ ผมไม่อยากให้ใครต้องนั่งกด sync ด้วยมือทุกวัน เลยทำให้เครื่องผู้ดูแลรวบรวมแล้วส่งเองตามเวลา แต่ทำไปได้ไม่นานผมก็เริ่มกลัวสิ่งเดียว คือวันที่ export บนเครื่องต้นทางถูกตัดกลางทาง เพราะดิสก์เต็ม โปรเซสโดนฆ่า หรือเน็ตหลุดตอนเขียนไฟล์ แพ็กเกจที่ออกมาจะดูปกติทุกอย่าง แต่มีรายการอยู่แค่ครึ่งเดียว ถ้าฝั่งเว็บเชื่อมันแล้วทำตามตรง ๆ ข้อมูลจริงที่ "ไม่อยู่ในแพ็กเกจ" จะถูกมองว่าถูกลบที่ต้นทาง
กลไกทั้งหมดเลยออกแบบรอบความกลัวข้อนี้ข้อเดียว ว่าทำอย่างไรไม่ให้แพ็กเกจที่ผิดปกติเขียนทับของจริงโดยอัตโนมัติ
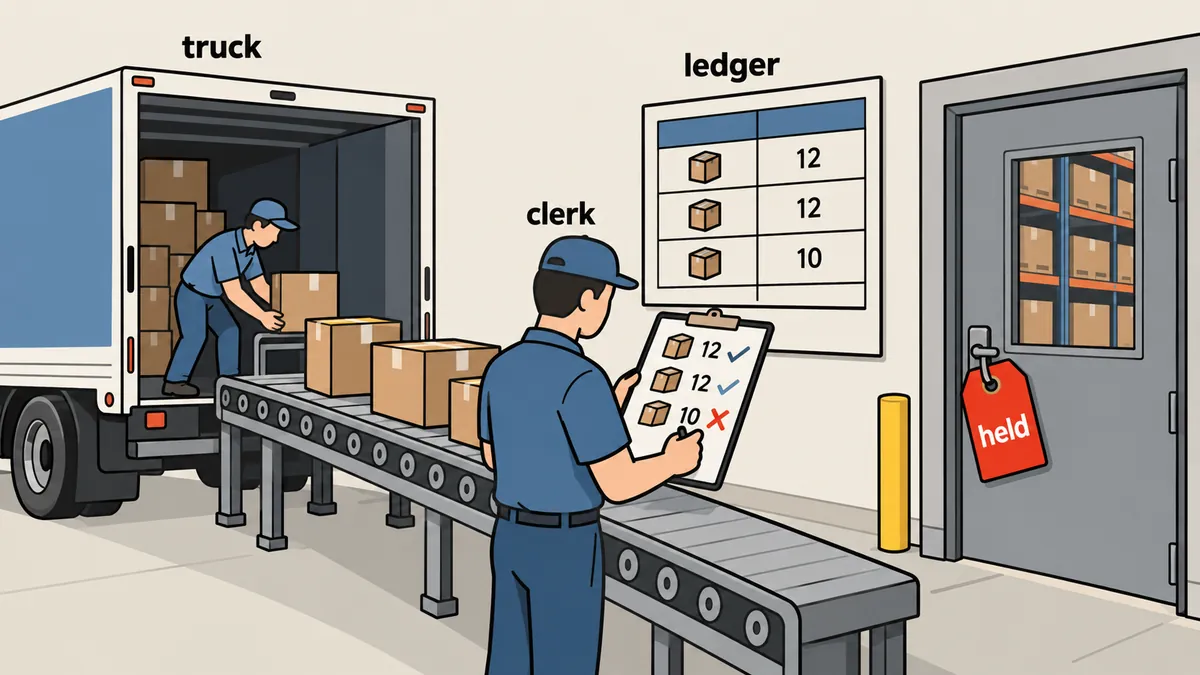
ตัวเลขเกณฑ์ (100, 50, 5.0 เปอร์เซ็นต์ และอื่น ๆ) เป็นค่าที่ตั้งไว้จริงของงานนี้ ส่วนจำนวนรายการของลูกค้าผมไม่เปิด และชื่อคำสั่งกับชื่อตัวแปรลับเปลี่ยนเป็นชื่อกลาง ๆ หมด เกณฑ์ที่เหมาะกับข้อมูลของคุณอาจต่างจากนี้มาก
โครงทั้งสายตั้งแต่เครื่องผู้ดูแลถึงเว็บจริง
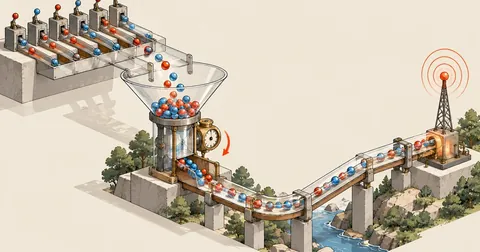
เส้นทางของแพ็กเกจไหลตามนี้ เครื่องผู้ดูแลรวบรวมรายการที่เปลี่ยนเป็น zip หนึ่งไฟล์ ประกอบด้วย manifest, ไฟล์ items.jsonl ที่มีหนึ่งรายการต่อหนึ่งบรรทัด และไฟล์ media ภายใต้เพดาน 60 MB (เพดานอัปโหลดของเว็บจริงคือ 64 MB เลยเว้นไว้ให้ส่วนหัวของคำขอ) ส่งผ่าน API ด้วย token เข้า inbox ฝั่งเว็บ แล้ว cron ฝั่งเว็บค่อยหยิบแพ็กเกจล่าสุดไปนำเข้า
ฝั่งเครื่องผู้ดูแลมีงานสองอย่าง คือรวมรายการและตรวจเพดานขนาดก่อนส่ง ตัวอย่างโครงแบบย่อ
import json, zipfile, pathlib

LIMIT = 60 * 1024 * 1024        # เพดานของเรา เว้นจาก 64 MB ของฝั่งเว็บ

def build_package(items, media_files, out="package.zip"):
    with zipfile.ZipFile(out, "w", zipfile.ZIP_DEFLATED) as z:
        z.writestr("manifest.json", json.dumps({
            "count": len(items),
            "created_at": __import__("time").strftime("%Y-%m-%dT%H:%M:%S"),
        }))
        z.writestr("items.jsonl", "\n".join(json.dumps(i, ensure_ascii=False) for i in items))
        for m in media_files:
            z.write(m, arcname="media/" + pathlib.Path(m).name)
    size = pathlib.Path(out).stat().st_size
    if size > LIMIT:
        raise SystemExit(f"[STOP] package {size} bytes เกินเพดาน {LIMIT} ต้องแบ่งส่ง")
    return out
# ส่งเข้า inbox ฝั่งเว็บ token ใส่ผ่านไฟล์ ไม่พิมพ์ลงบรรทัดคำสั่งที่เก็บใน history
curl -sS -X POST "https://example.com/api/sync/packages" \
  -H "Authorization: Bearer <TOKEN>" \
  -F "[email protected]"
ผมให้เครื่องผู้ดูแลตรวจขนาดเองก่อนส่ง เพราะถ้าปล่อยให้เว็บปฏิเสธเพราะเกินเพดานก็ไม่เป็นไร แต่การรู้ตั้งแต่ต้นทางว่าต้องแบ่งส่งดีกว่ารู้จากข้อความ error ปลายทาง
ด่านเทียบกับของจริง: เกณฑ์สัมบูรณ์ไม่พอ
ตอนแรกผมคิดจะตั้งเกณฑ์แบบเดียว คือถ้ารายการที่หายไปมากกว่าเท่านั้นเท่านี้ให้หยุด แต่เกณฑ์สัมบูรณ์ตัวเดียวพังง่ายมาก ถ้าชุดข้อมูลโต 10 เท่าเกณฑ์ก็ไม่เข้ากับของจริงอีกต่อไป ส่วนตัวผมเลยเพิ่มเกณฑ์สัดส่วนที่เทียบกับฐานข้อมูลจริงเท่านั้น คือ missing_pct รายการจริงที่ "ไม่อยู่ในแพ็กเกจ" ต้องไม่เกิน 5 เปอร์เซ็นต์ ถ้าเกินแปลว่า export น่าจะถูกตัด ไม่ใช่ผู้ดูแลตั้งใจลบเยอะขนาดนั้น
<?php
// config/sync_import.php
return [
    'gates' => [
        'new'         => 100,   // รายการใหม่เกินนี้ = ผิดปกติ
        'changed'     => 50,    // รายการเปลี่ยนเกินนี้ = ผิดปกติ
        'removed'     => 100,   // ถูกลบพร้อมกันเกินนี้ = ผิดปกติ
        'missing_pct' => 5.0,   // ของจริงที่ไม่อยู่ในแพ็กเกจเกินกี่ % = export ถูกตัด
    ],
    'dump_exclude' => ['cache', 'sessions'],   // ตารางที่เปลี่ยนเองตามธรรมชาติ ไม่ต้อง dump
    'dump_keep'    => 14,
];
<?php
// ตัดสินว่าแพ็กเกจนี้ต้อง held หรือไม่ ก่อนแตะข้อมูลจริง
function evaluateGates(array $diff, int $liveCount, array $gates): array
{
    $reasons = [];
    if ($diff['new'] > $gates['new'])         $reasons[] = "new={$diff['new']}";
    if ($diff['changed'] > $gates['changed']) $reasons[] = "changed={$diff['changed']}";
    if ($diff['removed'] > $gates['removed']) $reasons[] = "removed={$diff['removed']}";

    $missingPct = $liveCount > 0 ? 100.0 * $diff['missing'] / $liveCount : 0.0;
    if ($missingPct > $gates['missing_pct']) {
        $reasons[] = sprintf('missing=%.1f%%', $missingPct);
    }
    return $reasons;                       // ว่าง = ผ่าน, ไม่ว่าง = held พร้อมเหตุผล
}
มีรายละเอียดหนึ่งเรื่องการลบที่ต้นทาง ปัจจุบันการลบที่ต้นทางไม่ทำให้แพ็กเกจ held แล้ว ระบบจะเปิด "การตัดสินใจเรื่องต้นทางถูกลบ" ให้เจ้าของดูแยกต่างหาก ยกเว้นกรณีที่ลบจำนวนมากพร้อมกัน ซึ่งชนเกณฑ์ removed อยู่แล้ว
นับจำนวนที่หายไป
- ต้องแก้เลขทุกครั้งที่ข้อมูลโต
- ข้อมูลน้อยจับ export ที่ถูกตัดไม่ได้
- ข้อมูลมากหยุดบ่อยเกิน
missing_pct เทียบฐานข้อมูล
- ขยายตามขนาดข้อมูลเอง
- จับ export ที่ขาดกลางทางได้ตรงตัว
- ใช้คู่กับเกณฑ์สัมบูรณ์เป็นตาข่ายสองชั้น
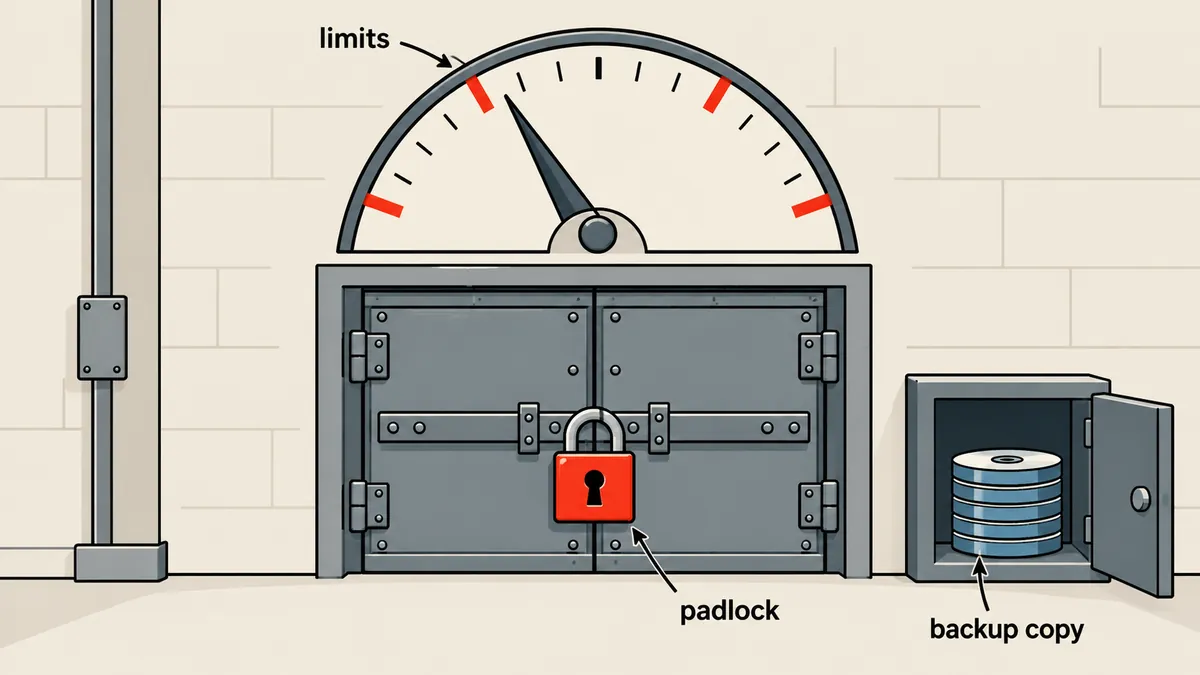
สถานะ held ต้องมีทางออกที่ชัด
ด่านที่ไม่มีทางออกคือด่านที่คนจะปิดทิ้งในที่สุด ถ้า held แล้วไม่มีใครรู้จะทำอย่างไรต่อ สุดท้ายคนก็ปิดด่านแล้วบอกว่า "ปล่อยไปเถอะ" ผมเลยทำให้แพ็กเกจที่ held อนุมัติได้สองทาง คือสั่งผ่านบรรทัดคำสั่งว่าอนุมัติแพ็กเกจล่าสุด หรือกดในหน้าแอดมินที่แสดงเหตุผลของแต่ละเกณฑ์ที่ชน ชื่อคำสั่งจริงผมไม่เปิดในที่นี้ เจ้าของเห็นค่าที่ชนเป็นตัวเลขตรง ๆ เช่น missing=7.3% แล้วตัดสินใจเองว่าจะอนุมัติหรือปฏิเสธ
สถานะสุดท้ายของแพ็กเกจมีห้าแบบ
| สถานะ | ความหมาย |
|---|---|
| done | นำเข้าเสร็จสมบูรณ์ |
| held | ชนเกณฑ์ รอเจ้าของอนุมัติ |
| failed | นำเข้าแล้วเกิดข้อผิดพลาดกลางทาง |
| superseded | มีแพ็กเกจใหม่กว่ามาแทน ข้ามไม่นำเข้า |
| rejected | เจ้าของสั่งข้ามเอง |
สถานะ superseded มีประโยชน์ตอนที่สองแพ็กเกจซ้อนกัน เพราะ cron นำเข้าเฉพาะแพ็กเกจล่าสุดที่ยังไม่ได้ประมวลผล แพ็กเกจเก่ากว่าไม่ต้องนำเข้าอีกแล้ว เนื่องจากแพ็กเกจใหม่คือสภาพล่าสุดของต้นทางอยู่แล้ว
ก่อนนำเข้า dump ก่อนเสมอ แต่ restore เป็นเรื่องของคน
พอผ่านด่านแล้ว ก่อนแตะข้อมูลจริงทุกครั้งระบบ dump ฐานข้อมูลทั้งหมดไว้ ยกเว้นตารางที่เปลี่ยนเองตามธรรมชาติซึ่งตั้งไว้ในค่า dump_exclude ไฟล์ dump ไปอยู่ในโฟลเดอร์สิทธิ์ 700 ตัวไฟล์สิทธิ์ 600 เก็บย้อนหลัง 14 ชุด เพราะ dump ฐานข้อมูลคือของที่ควรอ่านได้เฉพาะเจ้าของระบบเท่านั้น
# dump ก่อนนำเข้า โฟลเดอร์ 700 ไฟล์ 600 เก็บ 14 ชุด
umask 077
DEST=/var/backups/import-dumps
mkdir -p "$DEST" && chmod 700 "$DEST"

STAMP=$(date +%Y%m%d-%H%M%S)
mysqldump --single-transaction --routines --triggers \
  --ignore-table=appdb.cache --ignore-table=appdb.sessions \
  appdb | gzip > "$DEST/pre-import-$STAMP.sql.gz"
chmod 600 "$DEST/pre-import-$STAMP.sql.gz"

# เก็บแค่ 14 ชุดล่าสุด
ls -1t "$DEST"/pre-import-*.sql.gz | tail -n +15 | xargs -r rm -f
จากนั้นนำเข้ารายการ คัดลอกไฟล์ media แล้ว rebuild แคชด้วยวิธีเตรียมไว้ข้างข้างแล้วสลับทีเดียว ไม่ใช้คำสั่งล้างแคชทั้งก้อนที่ทำให้หน้าเว็บช้าลงชั่วคราว (เรื่องนี้ผมเล่าไว้ในบทความ zero-gap deploy แล้ว)
กฎข้อนี้สำคัญที่สุดของทั้งสาย ถ้าการนำเข้า failed กลางทาง ระบบไม่ restore ฐานข้อมูลจาก dump ให้เอง แต่หยุดแล้วรอให้คนมาตัดสินใจ เหตุผลคือ failed กลางทางแปลว่าฐานข้อมูลอยู่ในสถานะครึ่ง ๆ กลาง ๆ และเราไม่รู้ว่าความล้มเหลวมาจากแพ็กเกจ จากเครื่อง หรือจากอะไร การ restore อัตโนมัติทับของที่อาจมีส่วนที่ถูกต้องอยู่ เป็นการตัดสินใจที่ผมไม่อยากให้เครื่องทำเอง ไฟล์ dump ถูกเก็บไว้ครบแล้ว คนรู้ค่อยสั่ง restore ทีหลังได้ตลอด
การมี dump ก่อนนำเข้าไม่ได้แปลว่าย้อนได้ทุกกรณี ข้อมูลที่เว็บรับเข้ามาระหว่างนั้น เช่นข้อมูลที่ผู้ใช้ส่งเข้ามา จะหายไปถ้า restore ทั้งก้อน การตัดสินใจ restore เลยต้องมีคนดูก่อนเสมอว่าจะเสียอะไรไปบ้าง และนี่คือเหตุผลที่ผมไม่ทำให้เครื่องทำเอง
ตัวตั้งเวลาฝั่งเครื่องผู้ดูแล และ exit code ที่ไม่ใช่ความล้มเหลว
ฝั่งเครื่องผู้ดูแลผมให้ systemd timer เรียกสคริปต์ซิงก์ทุก 6 ชั่วโมง คือ 02, 08, 14 และ 20 นาฬิกา โดยจำกัดให้ใช้ทรัพยากรเบา ๆ ไม่แย่งกับงานปกติของเครื่อง
# sync.service
[Unit]
Description=Push changed items to the web inbox

[Service]
Type=oneshot
ExecStart=/usr/local/bin/sync_daily.py
TimeoutStartSec=5.5h
Nice=15
IOSchedulingClass=idle
SuccessExitStatus=2 3

# sync.timer
[Timer]
OnCalendar=*-*-* 02,08,14,20:00:00
Persistent=true

[Install]
WantedBy=timers.target
บรรทัด SuccessExitStatus=2 3 คือรายละเอียดเล็กที่ผมเคยพลาด สคริปต์คืน exit code 2 เมื่อชนเกณฑ์ (STOP) และ 3 เมื่อปลายทางปฏิเสธแพ็กเกจ (BLOCKED) ทั้งสองอย่างเป็นพฤติกรรมที่ระบบตั้งใจให้เกิด ไม่ใช่ความล้มเหลวของโปรแกรม ถ้าไม่บอก systemd มันจะนับเป็น failed แล้ว unit แดงทุกครั้งที่ด่านทำงานถูก ทำให้คนที่เห็น unit แดงทุกวันเริ่มชินแล้วเมินตัวแดงจริงในที่สุด
บั๊กที่ทำให้รายงานซ้ำ: held ที่เสร็จทีหลัง
บั๊กนี้ผมเจอจากรายงานที่ออกมาซ้ำ แพ็กเกจหนึ่ง held ตอนที่ผู้ส่งเลิกรอไปแล้ว หลังจากนั้นเจ้าของมาอนุมัติ แพ็กเกจเลยนำเข้าสำเร็จจริง แต่ไฟล์ที่จำว่า "นำเข้าครั้งสุดท้ายคืออะไร" ซึ่งชื่อสมมติว่า last_imported.json ฝั่งเครื่องผู้ดูแลยังชี้ไปแพ็กเกจเก่า เพราะตอนที่ผู้ส่งเลิกรอ มันบันทึกผลว่า "ยังไม่เสร็จ" ไว้แล้วไม่ได้กลับมาอัปเดต
ผลคือรอบถัดไปเครื่องผู้ดูแลคิดว่ารายการชุดเดิมยังไม่เคยถูกนำเข้า เลยรวมส่งมาอีกรอบ และรายงานความเปลี่ยนแปลงชุดเดิมซ้ำอีกครั้ง เจ้าของเห็นตัวเลขอนุมัติกับเปลี่ยนแปลงชุดเดิมโผล่มาสองรอบ ซึ่งตัวเลขเดิมนั้นเคยจัดการไปแล้วจริง
ผมแก้ด้วยการ reconcile ผลสุดท้ายที่มาช้า คือก่อนเริ่มรอบใหม่ เครื่องผู้ดูแลถามสถานะของแพ็กเกจที่ค้างรอบก่อนจากฝั่งเว็บ ถ้าฝั่งเว็บบอกว่า done แล้ว ก็ปรับ last_imported.json ให้ตรงก่อนค่อยรวมรายการ
def reconcile_late_results(state, api):
    """แพ็กเกจที่เคยค้าง held/ไม่ทราบผล ถามฝั่งเว็บว่าตอนนี้เป็นอย่างไร"""
    for pkg_id in list(state.get("pending", [])):
        status = api.package_status(pkg_id)        # done / held / failed / superseded / rejected
        if status == "done":
            state["last_imported"] = pkg_id         # ผลมาช้า แต่สำเร็จจริง
            state["pending"].remove(pkg_id)
        elif status in ("failed", "rejected", "superseded"):
            state["pending"].remove(pkg_id)         # จบแล้วโดยไม่นำเข้า
        # held ยังอยู่ในรายการ รอรอบหน้า ไม่ส่งซ้ำ
    return state
- ก่อนรวมแพ็กเกจรอบใหม่ ดึงสถานะของแพ็กเกจที่ค้างจากรอบก่อนทั้งหมด
- ถ้าเป็น done ให้ย้ายตัวชี้ last_imported ไปที่แพ็กเกจนั้นก่อน
- ถ้ายังเป็น held ให้ไม่ส่งชุดเดิมซ้ำ รอเจ้าของตัดสินใจ
- ค่อยรวมรายการที่เปลี่ยนนับจากตัวชี้ที่ถูกต้องแล้ว
ทดสอบด้วยแพ็กเกจจำลอง
ด่านประเภทนี้ทดสอบกับของจริงไม่ได้ ผมสร้างแพ็กเกจจำลองสามแบบแล้วดูว่าได้สถานะถูกต้องหรือไม่
- แพ็กเกจที่ตัดรายการทิ้งไปราว 10 เปอร์เซ็นต์ ต้องได้ held ด้วยเหตุผล missing เกิน 5.0
- แพ็กเกจที่มีรายการใหม่ 101 ตัว ต้องได้ held ด้วยเหตุผล new เกิน 100 และถ้าเป็น 100 ตัวพอดีต้องผ่าน
- สองแพ็กเกจซ้อนกัน ต้องนำเข้าเฉพาะอันล่าสุด และอันเก่าเป็น superseded
# ทดสอบด่านบนข้อมูลสำเนา ไม่ใช่ฐานข้อมูลจริง
php artisan inbox:import --dry-run --package=/tmp/truncated-10pct.zip
# ต้องได้สถานะ held พร้อมบรรทัด reason ที่มี missing=...% (ชื่อคำสั่งกับ flag เป็นตัวอย่างสมมติ)
สิ่งที่ผมเอาไปใช้ต่อ
ถ้าต้องสรุปเป็นข้อ ๆ ส่วนตัวผมถือห้าข้อนี้เป็นหลัก
- ด่านเทียบสัดส่วนกับ "ของจริง" ดีกว่าตั้งเกณฑ์สัมบูรณ์อย่างเดียว เพราะ missing_pct จับ export ที่ถูกตัดได้ตรง
- สถานะ held ต้องมีทางอนุมัติที่ชัดและเห็นเหตุผลเป็นตัวเลข ไม่งั้นคนจะปิดด่านทิ้ง
- dump ก่อนทุกครั้ง แต่การ restore เป็นการตัดสินใจของคน ไม่ใช่ของเครื่อง
- exit code ที่ไม่ใช่ความล้มเหลวต้องไม่ทำให้ unit ล้มเหลว
- สถานะต้องปรับให้ตรงกันเมื่อผลมาช้า ไม่งั้นรายงานจะซ้ำ
เรื่องหยุดการซิงก์เมื่อข้อมูลเปลี่ยนมากผิดปกติอีกมุมหนึ่ง ผมเล่าไว้ใน weekly-delta-sync-stop-gates-determinism ซึ่งเป็นด่านของฝั่ง crawl ส่วนบทความนี้เน้นที่ inbox ฝั่งเว็บ การ dump และสถานะ ถ้าเป็นกรณีเครื่องต้นทางอยู่หลัง NAT ต้องส่งคำสั่งกลับด้วย ดูต่อที่ onprem-nat-cloud-sync-queue-ack ได้ครับ
เกณฑ์ที่ผมตั้งเป็นแค่ค่าของงานนี้ ใครจะปรับให้เข้ากับข้อมูลของตัวเองก็ตามสะดวก ขอแค่มีสัดส่วนเทียบกับของจริงหนึ่งตัวกับทางอนุมัติที่ชัด ตรงไหนผมอธิบายตกหล่นหรือพิมพ์ผิด เดี๋ยวกลับมาแก้เพิ่มให้ภายหลังครับ
อยากให้เราทำให้ไหม?
ให้เราช่วยติดตั้ง ตั้งค่า ย้ายระบบ หรือแก้ปัญหาเซิร์ฟเวอร์ เพื่อให้คุณมีเวลาไปทำงานที่สำคัญกว่า
เคยเจองานแบบนี้ไหม? ติดตรงไหน?
มาแลกวิธีกันต่อในบอร์ด LinuxThai
ความคิดเห็น 0
ยังไม่มีความคิดเห็น — เป็นคนแรกเลย