อัปเดต apt สองเครื่องแบบ canary พร้อม health gate และบั๊ก awk
อัปเดตทุกเครื่องพร้อมกันคือการเดิมพันว่าแพ็กเกจวันนี้ไม่พัง ถ้ามีสองเครื่องที่สลับกันรับงานได้ ก็ควรเอาเครื่องหนึ่งไปเสี่ยงก่อน แล้วให้อีกเครื่องรอดูผลสักวัน
สรุปใน 1 นาที
- อาการ/ปัญหา
- อัปเดตทุกเครื่องพร้อมกันเสี่ยงว่าแพ็กเกจวันนี้พังทั้งสองเครื่อง
- ใครควรอ่าน
- คนดูแล VPS หน้าเว็บสองเครื่องที่เป็นคู่สำรองกัน
- ทางแก้แบบสั้น
- ให้เครื่อง A อัปเดตก่อนแบบ canary ส่วนเครื่อง B ลงเมื่อ A รันมาแล้ว 24 ชั่วโมง มีสำรอง ทดสอบ config restart ทีละบริการ และตรวจ health check
พอดีผมมีเซิร์ฟเวอร์หน้าบ้านสองเครื่องของเว็บลูกค้ารายหนึ่ง ทำหน้าที่เป็นคู่สำรองกัน ผมปิด unattended-upgrades ของ Debian ไปแล้ว (ส่วน apt-daily ที่รีเฟรชรายการแพ็กเกจยังเปิดไว้) เพราะมันอัปเดตทั้งสองเครื่องในเวลาเดียวกัน ด้วยแพ็กเกจชุดเดียวกัน ถ้าแพ็กเกจวันนั้นมีปัญหา ก็พังพร้อมกันทั้งคู่ ซึ่งทำให้การมีเครื่องสำรองไม่มีความหมายเลย ผมเลยเขียนสคริปต์อัปเดตเองรันจาก systemd timer โดยใช้แนวคิด canary คือเครื่อง A ลงก่อน แล้วเครื่อง B ตามหลัง 24 ชั่วโมง ระหว่างทางผมเจอบั๊กใน awk เพียงบรรทัดเดียวที่ทำให้กลไก "ตามหลัง" ไม่ทำงานเลย บทความนี้เล่าทั้งตัวสคริปต์และบั๊กนั้น ชื่อเครื่อง เวลา และ path ในบทความเป็นตัวอย่างที่ผมเขียนใหม่
เวลารัน วันรีบูต และค่า hold ในบทความนี้เป็นตัวอย่าง ไม่ใช่ตารางของเครื่องจริง ก่อนเอาไปใช้ให้ทดสอบบนเครื่องที่ไม่ได้รับงานจริงก่อน และอย่าให้สคริปต์ที่รีสตาร์ตบริการอัตโนมัติรันครั้งแรกโดยไม่มีคนเฝ้า
ทำไมถึงไม่ปล่อยให้อัปเดตพร้อมกัน
คู่สำรองที่อัปเดตพร้อมกันได้ความเสี่ยงเท่ากับเครื่องเดียว แพ็กเกจที่ถูกแก้ทีหลังหรือถูกถอนภายในวันเดียวเกิดขึ้นได้จริง ถ้าผมไม่ใช่เครื่องแรกที่ลงมัน ผมก็ไม่ต้องเป็นคนแรกที่เจอ ไอเดียเลยง่ายมาก ให้เครื่อง A ลงของใหม่ทันที (hold 0 ชั่วโมง) ส่วนเครื่อง B ลงเฉพาะแพ็กเกจที่เห็นว่ามีใหม่มาอย่างน้อย 24 ชั่วโมงแล้ว นั่นแปลว่าของทุกชิ้นที่ B ลงผ่านการรันบน A มาแล้วเต็มวัน
จุดที่ผมชอบคือสองเครื่องไม่ต้องคุยกันเลย ไม่มี channel ไม่มีไฟล์ที่ต้องแชร์ แต่ละเครื่องจดเองว่าเห็นแพ็กเกจเวอร์ชันนี้ครั้งแรกเมื่อไร แล้วดูนาฬิกาตัวเอง ที่ทำให้ B ตามหลัง A ได้ก็เพราะ B ตั้ง HOLD_HOURS ไว้ 24 ส่วน A ตั้งไว้ 0 เท่านั้น ตัวสคริปต์เป็นตัวเดียวกันทั้งสองเครื่อง ต่างกันที่ไฟล์ conf
# /etc/staged-update.conf  (ตัวอย่าง)  ค่าของ A
HOLD_HOURS=0
REBOOT_DOW=2        # วันที่อนุญาตให้รีบูต (2 = อังคาร)
REBOOT_HOUR=5
PEER=host-b         # เครื่องคู่ ใช้เช็กว่าตอบ ping ก่อนรีบูต
# ค่าของ B  ต่างกันแค่สามบรรทัด
HOLD_HOURS=24
REBOOT_DOW=3        # รีบูตคนละวันกับ A
PEER=host-a
ไฟล์ seen.txt กับบั๊ก awk ที่ทำให้ไม่เคยบันทึกอะไร
หัวใจของ hold คือไฟล์ seen.txt หนึ่งบรรทัดต่อแพ็กเกจ รูปแบบ package=version first_seen_epoch สคริปต์รันแต่ละรอบทำสามอย่าง ขอรายการที่อัปเกรดได้จาก apt แล้วเอามารวมกับ seen.txt เดิม ใครเคยเห็นแล้วเก็บเวลาเดิมไว้ ใครใหม่ใส่เวลาตอนนี้ จากนั้นเลือกเฉพาะแพ็กเกจที่เวลาห่างจากตอนนี้ไม่น้อยกว่า HOLD_HOURS
now=$(date +%s)
apt list --upgradable 2>/dev/null \
  | awk 'NR>1 { split($1,a,"/"); print a[1] "=" $2 }' | sort > avail.txt

# รวม seen.txt เดิมกับ avail.txt ใหม่ ใครเคยเห็นเก็บเวลาเดิม ใครใหม่ใส่ now
awk -v now="$now" '
  NR==FNR { seen[$1]=$2; next }
  { print $1, ($1 in seen) ? seen[$1] : now }
' seen.txt avail.txt > seen.new && mv seen.new seen.txt
โค้ดข้างบนคือรุ่นแรกที่ผมเขียน และมันพังโดยไม่มีอะไรฟ้อง ทั้ง awk ไม่มี error, mv สำเร็จ, สคริปต์ผ่านทุกด่าน แต่ seen.txt ว่างเปล่าทุกรอบ เลยไม่มีแพ็กเกจไหนอายุถึง hold สักตัว ปัญหาอยู่ที่ NR==FNR ซึ่งเป็นสำนวนยอดนิยมของ awk สำหรับถามว่า "ตอนนี้กำลังอ่านไฟล์แรกอยู่ไหม" เพราะ NR คือเลขบรรทัดรวมทุกไฟล์ ส่วน FNR คือเลขบรรทัดในไฟล์ปัจจุบัน สองค่านี้เท่ากันเฉพาะตอนอ่านไฟล์แรก แต่ถ้าไฟล์แรกว่างเปล่า ไม่มีบรรทัดไหนให้ NR เพิ่ม พอ awk เริ่มอ่านไฟล์ที่สอง NR กับ FNR ก็ยังเท่ากันอยู่ awk เลยเข้าใจว่า avail.txt คือ "ไฟล์แรก" เอาไปใส่ในอาร์เรย์ seen แล้ว next ทุกบรรทัด ไม่มีอะไรถูกพิมพ์เลย ผลคือ seen.new ว่าง แล้ว mv ทับ seen.txt ที่ว่างอยู่แล้ว วนแบบนี้ไปตลอด "แพ็กเกจที่เห็นแล้ว" ไม่เคยสะสม
NR==FNR
ใช้ได้เมื่อไฟล์แรกมีอย่างน้อยหนึ่งบรรทัด พอไฟล์แรกว่าง awk นับไฟล์ที่สองเป็นไฟล์แรกแทน ไม่พิมพ์อะไรออกมา และไม่มี error บอก
FILENAME==ARGV[1]
เทียบชื่อไฟล์ที่กำลังอ่านกับอาร์กิวเมนต์แรกตรง ๆ ไม่ขึ้นกับจำนวนบรรทัดของไฟล์ไหนเลย ไฟล์แรกจะว่างก็ไม่เป็นไร
awk -v now="$now" '
  FILENAME==ARGV[1] { seen[$1]=$2; next }
  { print $1, ($1 in seen) ? seen[$1] : now }
' seen.txt avail.txt > seen.new && mv seen.new seen.txt
ผมเขียนบทเรียนไว้เป็นคอมเมนต์ในสคริปต์ว่าถ้าไฟล์แรกอาจว่าง อย่าใช้ NR==FNR และให้ทดสอบครั้งแรกบนสถานะว่างเสมอ เพราะกรณีที่ seen.txt ว่างคือกรณีแรกที่เครื่องใหม่ทุกเครื่องเจอ ใครอยากเห็นกับตาก็ลองเองได้ในสองบรรทัด
: > seen.txt; printf 'curl=7.88.1\n' > avail.txt
awk 'NR==FNR{seen[$1]=$2;next}{print $1,"new"}' seen.txt avail.txt   # ไม่มีเอาต์พุต
awk 'FILENAME==ARGV[1]{seen[$1]=$2;next}{print $1,"new"}' seen.txt avail.txt   # curl=7.88.1 new
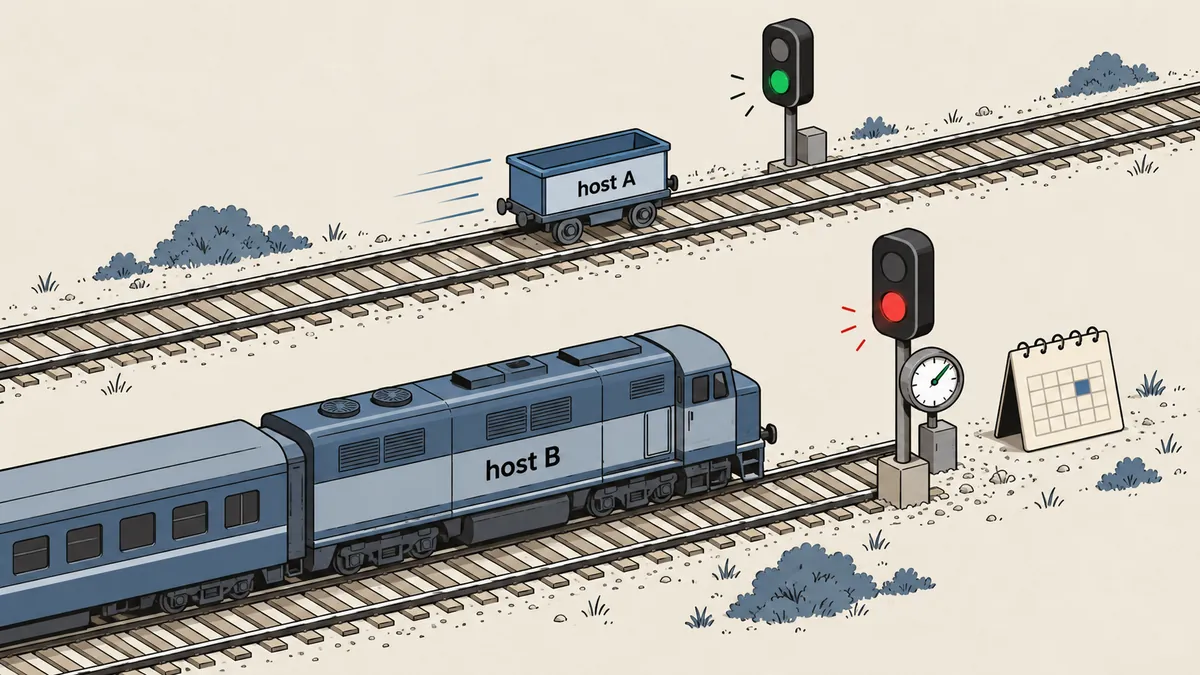
หลังรวมเสร็จ การเลือกแพ็กเกจที่พร้อมติดตั้งก็แค่คำนวณอายุ แล้วติดตั้งด้วย --only-upgrade เพื่อไม่ให้ apt ลากแพ็กเกจใหม่ที่ไม่เกี่ยวเข้ามา ระบุเวอร์ชันตรง ๆ ด้วยเครื่องหมายเท่ากับ จะได้ลงเวอร์ชันที่ผ่าน hold จริง ไม่ใช่เวอร์ชันล่าสุดที่เพิ่งโผล่หลังจากนั้น
awk -v now="$now" -v hold="$HOLD_HOURS" '(now-$2) >= hold*3600 { print $1 }' seen.txt > ready.txt
[ -s ready.txt ] || { echo "nothing ready"; exit 0; }
xargs -a ready.txt apt-get install -y --only-upgrade \
  -o Dpkg::Options::=--force-confold -o Dpkg::Options::=--force-confdef
ก่อนลงต้องมีทางถอยและทางเงียบ
ตัวติดตั้งเป็นเรื่องสั้น ส่วนที่เหลือเป็นของที่ทำให้มันปลอดภัยพอจะปล่อยให้รันเองตอนผมหลับ ผมไล่ตามลำดับที่สคริปต์ทำ
- ล็อกด้วย flock กันสองรอบทับกัน ถ้ามีรอบเก่าค้างอยู่ รอบใหม่ออกเงียบ ๆ
- รัน health check ก่อนเริ่ม ถ้าเครื่องพังอยู่แล้วก็ไม่อัปเดตทับ แจ้งเตือนแล้วจบ เพราะเราจะแยกไม่ออกว่าใครทำพัง
- เช็กดิสก์ว่างมากกว่า 1 GB เพราะ dpkg ที่เขียนไม่จบกลางทางแย่กว่าไม่อัปเดต
- เขียนเวลา mute ไว้ในไฟล์ให้ระบบแจ้งเตือนรายนาทีเงียบได้สูงสุด 90 นาที เพื่อไม่ให้การ restart ที่ตั้งใจทำถูกนับเป็นเหตุ แล้วลบไฟล์นี้ตอนจบเสมอ
- สำรอง tar ของ /etc รายการเวอร์ชันจาก dpkg และ dump ฐานข้อมูลแต่ละก้อนด้วย --single-transaction เก็บไว้ 14 วัน
- ติดตั้ง ถ้าพังกลางทางลอง
dpkg --configure -aหนึ่งครั้ง
exec 9>/run/lock/staged-update.lock
flock -n 9 || exit 0

health_check || { alert "pre-check failed, skip update"; exit 1; }

avail_kb=$(df --output=avail / | tail -n 1)
[ "$avail_kb" -gt 1048576 ] || { alert "disk < 1 GB, skip"; exit 1; }

echo $(( $(date +%s) + 5400 )) > /run/alert.mute_until      # mute สูงสุด 90 นาที
trap 'rm -f /run/alert.mute_until' EXIT

BK=/var/backups/staged/$(date +%F)
mkdir -p "$BK"
tar -czf "$BK/etc.tgz" /etc
dpkg-query -W -f='${Package}=${Version}\n' > "$BK/dpkg.list"
for db in $(mariadb -N -e 'show databases' | grep -Ev '^(information_schema|performance_schema|sys)$'); do
  mariadb-dump --single-transaction "$db" | gzip > "$BK/db-$db.sql.gz"
done
find /var/backups/staged -mindepth 1 -maxdepth 1 -mtime +14 -exec rm -rf {} +
บรรทัด health_check ในสคริปต์ผมเป็นสคริปต์แยกอีกตัวที่ตรวจว่าบริการหลักทำงานและเว็บตอบได้ ผมจงใจไม่ลงรายการข้างในในบทความนี้ แต่หลักที่อยากย้ำคือ canary ที่ดีต้องมี health check ที่ตรวจว่า "เว็บตอบจริง" ไม่ใช่แค่ว่า service ขึ้นสถานะ active เพราะบริการที่ active แต่ตอบ 502 อยู่นั้นมีจริง
ทดสอบ config ทีละระบบ แล้วคืนเฉพาะที่พัง
พอลงเสร็จ ปัญหาที่ผมกลัวที่สุดไม่ใช่แพ็กเกจพัง แต่เป็นไฟล์ config ที่ถูกแตะระหว่างอัปเกรด แล้วบริการไม่ขึ้นตอน restart ผมเลยทดสอบทีละระบบด้วยคำสั่งตรวจ config ของมันเอง และถ้าระบบไหนไม่ผ่าน ก็คืนไฟล์เฉพาะระบบนั้นจาก tar ที่เพิ่งสำรอง ไม่แตะระบบอื่นที่ผ่านแล้ว
restore_dir() { tar -xzf "$BK/etc.tgz" -C / "$1"; }

nginx -t 2>/dev/null || { restore_dir etc/nginx; alert "nginx config restored"; }
sshd -t   2>/dev/null || { restore_dir etc/ssh;   alert "sshd config restored"; }
nft -c -f /etc/nftables.conf 2>/dev/null || { restore_dir etc/nftables.conf; alert "nft config restored"; }

# ตารางไฟร์วอลล์หาย (เช่น nftables ถูก reload แล้วเหลือแต่ว่าง) -> โหลดใหม่ แล้วรันตัวอัปเดต set allow ซ้ำ
nft list table inet fw >/dev/null 2>&1 || { systemctl restart nftables; /usr/local/sbin/web-allow-update.py; }
บรรทัดสุดท้ายผมวางไว้เพราะไฟร์วอลล์ของเครื่องนี้มีทั้งส่วนที่โหลดจากไฟล์และ set ที่เติมสดทีหลัง ถ้าตารางหายไป การ restart nftables อย่างเดียวคืนได้แค่ส่วนจากไฟล์ เลยต้องรันตัวเติม set ซ้ำอีกรอบ ผมอธิบายเรื่อง set ที่เติมสดไว้ใน origin รับเฉพาะ CDN กับบอทที่ยืนยันได้ ถ้าใครสนใจกลไกนั้นละเอียดกว่านี้
restart ทีละบริการ พร้อม health หลังแต่ละตัว
หลังอัปเกรด ไลบรารีที่ถูกแทนที่ทำให้บริการจำนวนหนึ่งยังรันโค้ดเก่าอยู่ในหน่วยความจำ needrestart บอกได้ว่าตัวไหนต้อง restart ผมไม่ปล่อยให้มัน restart ทุกตัวพร้อมกัน เพราะถ้าพังจะไม่รู้ว่าตัวไหนทำ วิธีของผมคือรีสตาร์ตทีละตัว เช็ก health หลังแต่ละตัว ลองใหม่ได้หนึ่งครั้ง และมีรายการข้ามไว้สำหรับของที่ restart กลางวันไม่ปลอดภัย
needrestart -b -r l | sed -n 's/^NEEDRESTART-SVC: //p' | while read -r svc; do
  case "$svc" in
    dbus*|systemd-*|getty*|user@*|auditd*) continue ;;   # ของแกน รอรีบูตรอบหน้าต่าง
  esac
  if [ "$svc" = "ssh.service" ] && ! sshd -t; then continue; fi    # config ssh เสีย ห้าม restart

  systemctl restart "$svc"
  if ! health_check; then
    sleep 5
    health_check || alert "health failed after restarting $svc"
  fi
done
ssh เป็นบริการเดียวที่ผมให้มีด่านเฉพาะตัว เพราะถ้า sshd config เสียแล้ว restart ก็คือล็อกตัวเองออก เลยต้องมี sshd -t ก่อนเสมอ ส่วน dbus กับ systemd-* ผมปล่อยไว้รอรีบูต เพราะ restart กลางวันมักไม่คุ้ม
หลังจากนั้น ถ้าทุกอย่างผ่านและไม่มี error ผมค่อยสั่ง AIDE รับ baseline ใหม่ให้ เพื่อให้รายงานรายวันไม่เต็มไปด้วยไฟล์ที่เปลี่ยนเพราะตั้งใจอัปเดต และถ้ามี error แม้ข้อเดียวก็ไม่ accept เพื่อให้คนเห็นความแตกต่างนั้น แล้วเช็ก health รอบสุดท้าย แจ้งเตือนเข้าแชทเฉพาะเมื่อล้มเท่านั้น ถ้าปกติเงียบ ผมไม่อยากได้ข้อความ "สำเร็จ" ทุกคืนเพราะมันกลายเป็นเสียงรบกวนที่สอนให้เลิกอ่าน
รีบูตเฉพาะเมื่อจำเป็น และต้องมีเครื่องคู่ตอบ
บริการที่ restart ได้ก็ restart แต่เคอร์เนลกับไลบรารีแกนต้องรีบูตเท่านั้น needrestart รายงานสถานะเคอร์เนลเป็น KSTA ค่า 2 หรือ 3 คือมีเคอร์เนลใหม่รออยู่ สคริปต์จะรีบูตเมื่อเข้าเงื่อนไขนี้ หรือมีบริการแกนต้องการ และต้องเป็นในหน้าต่างรายสัปดาห์ที่กำหนดไว้เท่านั้น แถมต้องเช็กก่อนว่าเครื่องคู่ตอบ ping อยู่ ไม่งั้นรีบูตเครื่องนี้ก็เท่ากับเหลือศูนย์เครื่อง
ksta=$(needrestart -b | sed -n 's/^NEEDRESTART-KSTA: //p')
core_pending=$(needrestart -b -r l | grep -Ec '^NEEDRESTART-SVC: (dbus|systemd-)')

in_window() { [ "$(date +%u)" = "$REBOOT_DOW" ] && [ "$(date +%H)" = "$REBOOT_HOUR" ]; }

if { [ "$ksta" = 2 ] || [ "$ksta" = 3 ] || [ "$core_pending" -gt 0 ]; } && in_window; then
  ping -c 2 -W 2 "$PEER" >/dev/null && systemctl reboot
fi
ทดสอบครั้งแรกอย่างไรให้ไม่กลัว
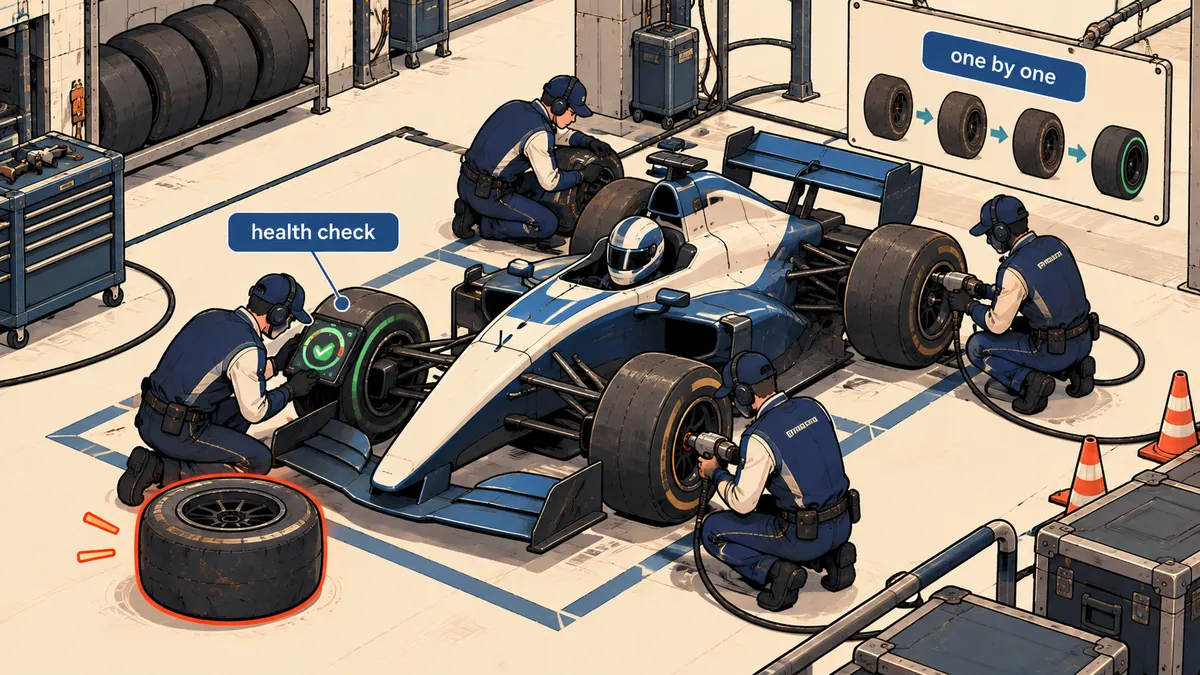
สคริปต์ที่ทำงานตอนผมหลับต้องผ่านการทดสอบที่น่าเบื่อกว่าสคริปต์ทั่วไป ผมไล่เป็นลำดับ ข้อแรกรันบนเครื่องที่ไม่รับงานจริง ด้วย seen.txt ว่างเปล่า เพราะนั่นคือสถานะที่เครื่องใหม่ทุกเครื่องจะเจอ และเป็นสถานะที่ทำให้บั๊ก awk โผล่ ข้อสองรันซ้ำอีกรอบทันทีเพื่อดูว่า seen.txt สะสมแล้ว คอลัมน์เวลาไม่ถูกเขียนทับเป็น now ใหม่ ข้อสามตั้ง HOLD_HOURS เป็นค่าสูงมากแล้วดูว่า ready.txt ว่างและสคริปต์ออกแบบเงียบ ๆ ไม่ติดตั้งอะไรเลย ข้อสี่จำลองความล้มโดยทำให้ health check คืนค่าผิดสักครั้ง ดูว่าได้แจ้งเตือนและไม่มีการ restart บริการตามมา
อีกเรื่องที่ผมให้ความสำคัญคือดูล็อกด้วยตาในช่วงสองสามสัปดาห์แรก แม้จะตั้งให้แจ้งเตือนเฉพาะตอนล้ม เพราะการที่ "ไม่มีข้อความเตือน" อาจแปลว่าทุกอย่างปกติ หรือแปลว่าสคริปต์ไม่ได้รันเลยก็ได้ สองกรณีนี้หน้าตาเหมือนกันถ้าไม่เปิดดู บั๊ก awk ข้างบนคือตัวอย่างพอดี มันไม่ทำให้เกิดข้อความเตือนสักข้อความ แต่ทำให้ฝั่ง B ไม่เคยลงอะไรเลย
ระบบที่แจ้งเตือนเฉพาะตอนล้มต้องมีสัญญาณอีกเส้นที่ยืนยันว่ามันยังรันอยู่จริง เช่นบรรทัดสรุปท้ายล็อกทุกรอบว่าเห็นกี่แพ็กเกจ ลงกี่ตัว ข้ามกี่ตัว ผมเปิดดูบรรทัดนี้แค่บรรทัดเดียวก็รู้ว่ากลไก hold ทำงานไหม
ข้อดี ข้อจำกัด และเรื่องที่ห้ามพึ่ง canary
canary แบบนี้ช่วยจับแพ็กเกจที่ถูกถอนหรือแก้ภายในวันเดียวได้จริง แต่ผมไม่อยากให้ใครมองว่าเป็นของวิเศษ มีข้อจำกัดชัดอยู่สามข้อ
ข้อแรก hold 24 ชั่วโมงแปลว่าแพตช์ความปลอดภัยเร่งด่วนมาถึง B ช้าไปหนึ่งวัน ถ้าเป็นช่องโหว่ที่ถูกโจมตีอยู่ ผมไม่รอ สั่งลงด้วยมือทั้งสองเครื่องเลย สคริปต์นี้ออกแบบมาสำหรับการอัปเดตตามปกติเท่านั้น ข้อสอง เครื่องคู่ต้องเหมือนกันพอที่ผลจะเป็นตัวแทนกัน ถ้า A กับ B ต่างกันมากทั้งซอฟต์แวร์และโหลด การที่ A ผ่านไม่ได้พิสูจน์อะไรกับ B ข้อสาม health check ที่หละหลวมทำให้ทั้งระบบหลอกตัวเอง ถ้า check แค่ว่า nginx กำลังรันอยู่ ก็จะผ่านทั้งที่เว็บตอบ 500 ทุกหน้า ซึ่งแย่กว่าไม่มี canary เพราะทำให้ผมมั่นใจเกินจริง
ส่วนตัวผมถือว่าสคริปต์แบบนี้คุ้มกับเวลาที่เขียน เพราะแต่ละคืนที่มันรันเงียบ ๆ ผมไม่ต้องเข้าไปอัปเดตมือ ส่วนค่า hold จะเป็น 24 หรือ 48 หรือ 72 ชั่วโมง ตามความเสี่ยงที่รับได้ของแต่ละคน สิ่งที่ยังค้างคือผมอยากเพิ่มการเทียบรายการแพ็กเกจระหว่าง A กับ B หลังรอบอัปเดต เพื่อให้เห็นเลยว่าสองเครื่องไม่ได้เพี้ยนจากกันเงียบ ๆ ตรงไหนผมเขียนหรืออธิบายพลาด เดี๋ยวกลับมาแก้เพิ่มให้ภายหลังครับ
อยากให้เราทำให้ไหม?
ให้เราช่วยติดตั้ง ตั้งค่า ย้ายระบบ หรือแก้ปัญหาเซิร์ฟเวอร์ เพื่อให้คุณมีเวลาไปทำงานที่สำคัญกว่า
เคยเจองานแบบนี้ไหม? ติดตรงไหน?
มาแลกวิธีกันต่อในบอร์ด LinuxThai
ความคิดเห็น 0
ยังไม่มีความคิดเห็น — เป็นคนแรกเลย