AI crawler ยิง ?add-to-cart= จนโหลดพุ่ง — บล็อกยังไงไม่ให้เสีย SEO

โหลดขึ้นไม่ได้แปลว่าโดนโจมตีเสมอไป บางทีมันคือบอทที่สุภาพมากตัวหนึ่ง เดินกดปุ่ม "หยิบใส่ตะกร้า" ให้ครบทุกสินค้าในร้าน วันละเจ็ดหมื่นกว่าครั้ง แล้วเว็บ WooCommerce ก็ทำสิ่งที่มันถูกออกแบบมาให้ทำ คือ bootstrap ใหม่ทั้งก้อนทุกครั้ง
สรุปใน 1 นาที
- อาการ/ปัญหา
- โหลดเซิร์ฟเวอร์ WooCommerce พุ่ง เพราะ AI crawler ตัวเดียวกด add-to-cart ทุกสินค้า คิดเป็น 84% ของทราฟฟิก
- ใครควรอ่าน
- คนดูแลร้าน WooCommerce ที่โหลดพุ่งผิดปกติและสงสัยว่าโดนบอทเดินเว็บ
- ทางแก้แบบสั้น
- เปิด log หาตัวต้นเหตุ แล้วปิดเป็นชั้น robots.txt, rel=nofollow, nginx limit_req เฉพาะเส้นทาง add-to-cart และ 403 หน้าส่วนตัว หน้าสินค้ายัง index ครบ
พอดีเช้าวันหนึ่งได้เมลเตือนจาก DirectAdmin ว่า load เฉลี่ยเกิน threshold แล้วในเมลชี้ว่าตัวกิน CPU คือ PHP-FPM pool ของร้านค้าร้านหนึ่งกับ mysql ตอนแรกผมนึกว่าโดนยิง แต่พอเปิด access log ของ vhost นั้นมาไล่จริง ๆ กลับเจอว่ามันไม่ใช่การโจมตีเลย เป็นบอทเก็บข้อมูล AI ตัวเดียวที่ไล่คลิกลิงก์ ?add-to-cart= ของสินค้าทุกตัวในร้าน ผมเลยอยากเอาเคสนี้มาเล่าเป็นแนวทาง เพราะร้านค้า WooCommerce ทุกร้านมีช่องนี้เปิดอยู่เหมือนกันหมด
ชื่อโดเมน ชื่อ user และ IP ในบทความเป็นของสมมติทั้งหมด (shop.example, shopuser, 203.0.113.x) ส่วนโครงสร้าง config ตัวเลข และผลทดสอบเป็นของจริงจากเครื่องที่ผมดูแลอยู่
เปิด log ดูก่อนว่าใครยิง อย่าเพิ่งเดา
คำสั่งชุดแรกที่ผมใช้ทุกครั้งเวลาโหลดพุ่งคือไล่นับ IP กับ user-agent ในไฟล์ log ของ vhost นั้นตรง ๆ ไม่ต้องพึ่งเครื่องมืออะไรเลย
LOG=/var/log/nginx/domains/shop.example.log

# ใครยิงเยอะสุด 10 อันดับแรกของวันนี้
awk '{print $1}' $LOG | sort | uniq -c | sort -rn | head -10

# IP นั้นเป็นใคร ใช้ UA อะไร
grep '^203.0.113.45 ' $LOG | awk -F'"' '{print $6}' | sort | uniq -c | sort -rn | head -3

# มันไปกดอะไรบ้าง
grep '^203.0.113.45 ' $LOG | awk '{print $7}' | cut -d'?' -f2 | cut -d'&' -f1 \
  | sort | uniq -c | sort -rn | head -10

# สถานะที่ตอบกลับไป
grep '^203.0.113.45 ' $LOG | awk '{print $9}' | sort | uniq -c | sort -rn
ผลที่ได้ออกมาชัดจนไม่ต้องตีความ
user-agent เป็นบอทเก็บข้อมูลของค่าย AI เจ้าหนึ่ง ไม่ใช่ UA ปลอม ไม่ได้ยิงถี่แบบ flood ด้วยซ้ำ มันแค่ขยัน และมันเดินตามลิงก์ที่ธีมของร้านวางไว้ให้เดินเท่านั้นเอง
ตัวเครื่องเองไม่ได้ใกล้ตายนะครับ 16 core โหลดขึ้นไป 10 คิดเป็นราว 63% RAM ว่างอีก 41 GB อัตรา 5xx ทั้งวันอยู่ที่ 0.3% แปลว่า threshold ที่ตั้งเตือนไว้ต่ำเกินไปด้วยส่วนหนึ่ง (ผมขยับจาก 6 ไปเป็น 14 ทีหลัง) แต่ที่ต้องแก้จริง ๆ คือทำไม request เจ็ดหมื่นกว่าอันนั้นถึงแพงขนาดนั้น
ทำไม ?add-to-cart= ถึงแพงกว่าหน้าอื่นทั้งเว็บ
หน้าสินค้าหรือหน้าแรกของร้าน ถ้ามี page cache อยู่ บอทกดเท่าไหร่ก็ไม่เจ็บ เพราะได้ HTML สำเร็จรูปกลับไป ไม่แตะ PHP ไม่แตะ MySQL แต่ ?add-to-cart= เป็นคนละเรื่องกันคนละโลก
cache ได้ ทุกคนได้ก้อนเดียวกัน
ไม่มี cookie เฉพาะคน ตอบจาก cache ได้เลย บอทกดพันครั้งก็ยังเบา และนี่คือหน้าที่เราอยากให้ Google เก็บไปทำ index
ผูกกับ session รายคน cache ไม่ได้
ต้องสร้าง session ใหม่ เขียนตะกร้าลง DB แล้ว 302 กลับ ตามด้วย /cart/ และ wc-ajax=get_refreshed_fragments อีกดอก เท่ากับ boot WordPress + WooCommerce เต็มก้อนทุกครั้ง
คิดเลขคร่าว ๆ ก็พอเห็นภาพ สินค้าในร้านมีหลักพันตัว บอทเดินครบหนึ่งรอบเท่ากับสั่งให้เครื่องบูต WooCommerce เป็นหมื่นครั้ง ทั้งที่ไม่มีคนซื้อสักคน pool ของ user นั้นตั้ง pm.max_children = 10 ไว้ พอ 10 slot ถูกจองด้วยงานตะกร้าหมด ลูกค้าจริงที่เข้ามาก็ต้องรอคิว นี่คือที่มาของอาการ "เว็บอืดเป็นพัก ๆ" ที่เจ้าของร้านแจ้งมาพอดี
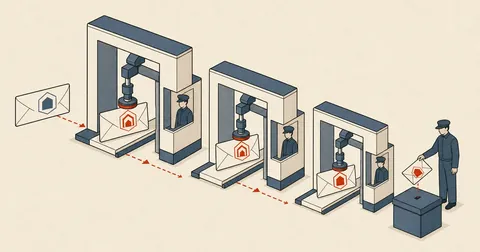
ชั้นที่ 1 robots.txt สำหรับบอทที่ยอมฟัง
ผมเริ่มจากชั้นที่ถูกที่สุดก่อนเสมอครับ ร้านนี้ไม่ได้ลงปลั๊กอิน SEO ที่ยึด robots.txt ไว้ เลยเขียนเป็นไฟล์จริงลงไปได้เลย ถ้าใครใช้ปลั๊กอิน SEO อยู่ต้องไปแก้ในหน้าปลั๊กอินแทน ไม่งั้นไฟล์จริงจะไม่ถูกใช้
# /home/shopuser/domains/shop.example/public_html/robots.txt
User-agent: *
Disallow: /*add-to-cart=
Disallow: /cart/
Disallow: /checkout/
Disallow: /my-account/
Disallow: /*?wc-ajax=
Disallow: /*?orderby=
Disallow: /*?add_to_wishlist=
Disallow: /*?yith_wcwl_

Sitemap: https://shop.example/sitemap_index.xml
จุดที่ผมอยากเน้นคือ ในลิสต์นี้ไม่มีบรรทัดไหนห้ามหน้าสินค้าหรือหน้าหมวดหมู่เลย ที่ห้ามทั้งหมดคือหน้าที่เป็นของส่วนตัวรายคน ซึ่งไม่ควรอยู่ในผลค้นหาอยู่แล้ว ต่อให้ Google เก็บไปก็เป็นหน้าตะกร้าว่างเปล่าที่ไม่มีประโยชน์กับใคร
# ตั้ง owner ให้ถูก ไม่งั้น DA/ปลั๊กอินเขียนทับไม่ได้ทีหลัง
chown shopuser:shopuser /home/shopuser/domains/shop.example/public_html/robots.txt
chmod 644 /home/shopuser/domains/shop.example/public_html/robots.txt

# เช็คว่าเสิร์ฟออกจริง ไม่ได้ถูกปลั๊กอินดักไว้
curl -s https://shop.example/robots.txt | head -20
บอท AI ตัวที่ก่อเรื่องรอบนี้เคารพ robots.txt ครับ หลังไฟล์ขึ้น ทราฟฟิกจากมันลดลงเห็นชัดในรอบเก็บข้อมูลถัดไป แต่ผมไม่หยุดแค่นี้ เพราะ robots.txt เป็นแค่ป้ายขอความร่วมมือ ไม่ใช่ประตูล็อก
บอทที่มีชื่อเสียงจะเคารพ แต่บอทเก็บข้อมูลบางตัวอ่านแล้วไม่สนใจ ในเคสเดียวกันนี้ผมยังเห็นบอทของ search engine อีกเจ้าวิ่งเข้า ?wc-ajax= ต่อทั้งที่ปิดไปแล้วในไฟล์ ถ้าอยากได้ผลจริงต้องมีชั้นที่บังคับได้ตามมาด้วย
ชั้นที่ 2 ใส่ rel=nofollow ที่ตัวลิงก์เลย
ปัญหาต้นทางจริง ๆ คือธีมร้านค้าวางลิงก์ "หยิบใส่ตะกร้า" ไว้ในหน้ารายการสินค้าทุกใบ แล้วลิงก์พวกนั้นเป็น <a href> ธรรมดาที่บอททุกตัวมองว่า "เดินต่อได้" ผมเลยเขียน mu-plugin สั้น ๆ ไปยัด rel="nofollow" ให้ทุกลิงก์ในลูปสินค้า ไม่ต้องแตะโค้ดธีม และไม่หายตอนธีมอัปเดต
<?php
// wp-content/mu-plugins/shop-bot-nofollow.php
// ใส่ rel=nofollow ให้ปุ่ม add-to-cart ในหน้ารายการสินค้า (ไม่แตะหน้าสินค้าเดี่ยว)

add_filter('woocommerce_loop_add_to_cart_link', function ($html) {
    if (strpos($html, 'rel=') === false) {
        $html = str_replace('<a ', '<a rel="nofollow" ', $html);
    }
    return $html;
}, 20);

// ธีมบางตัวสร้างปุ่มผ่าน args แทน string ตรง ๆ เลยต้องดักทั้งสองทาง
add_filter('woocommerce_loop_add_to_cart_args', function ($args) {
    $args['attributes']['rel'] = 'nofollow';
    return $args;
}, 20);
ทำไมต้องเป็น mu-plugin ไม่ใช่ปลั๊กอินปกติ เพราะไฟล์ใน mu-plugins/ โหลดอัตโนมัติ ปิดจากหน้า admin ไม่ได้ และไม่มีใครเผลอ deactivate ทิ้งตอนไล่ debug ปัญหาอื่น ส่วนตัวผมชอบวางของที่ "ห้ามหาย" ไว้ตรงนี้หมด
เช็คผลด้วยการนับลิงก์ในหน้าจริง อย่าเช็คด้วยตาเปล่า
curl -s https://shop.example/shop/ \
  | grep -o 'add_to_cart_button[^>]*' | grep -c 'rel="nofollow"'
# 12   <- ครบทั้ง 12 ลิงก์ในหน้ารายการ
ชั้นที่ 3 nginx map + limit_req เฉพาะเส้นทางเดียว
สองชั้นแรกคือขอความร่วมมือ ชั้นนี้คือบังคับ แต่ผมไม่อยากตั้ง rate limit ทั้งเครื่องเพราะบนเครื่องนี้มีเว็บอื่นอีกแปดสิบกว่าโดเมนที่ไม่เกี่ยวอะไรด้วย เทคนิคที่ใช้คือทำ map ให้ key ของ zone เป็นค่าว่างสำหรับทุกกรณีที่ไม่ใช่เป้าหมาย เพราะ nginx จะข้าม limit_req ทันทีเมื่อ key ว่าง เท่ากับเป็น no-op ให้เว็บที่เหลือทั้งเครื่อง
# /etc/nginx/nginx-includes.conf  (DirectAdmin include ไฟล์นี้ไว้ใน http{} ให้แล้ว
# และไม่เขียนทับตอน rewrite config — เป็นที่วางของ http-context ที่ปลอดภัยที่สุดบน DA)

map $host$request_uri $addtocart_key {
    default "";
    "~*shop\.example.*add-to-cart="  $binary_remote_addr;
}

limit_req_zone $addtocart_key zone=addtocart:10m rate=2r/s;
แล้วเรียกใช้ในไฟล์ nginx เฉพาะโดเมนของ user นั้น ซึ่งบน DirectAdmin คือไฟล์ .cust_nginx ที่รอด DA rewrite
# /usr/local/directadmin/data/users/shopuser/domains/shop.example.cust_nginx
# |CUSTOM| = DA แทรกให้ที่หัว server block ทั้งขา :80 และ :443
limit_req zone=addtocart burst=5 nodelay;
จบด้วยการ reload อย่างมีสติ ทดสอบ syntax ก่อนเสมอ เพราะไฟล์นี้ถ้าพังคือทุกโดเมนบนเครื่องพังพร้อมกัน
nginx -t && systemctl reload nginx

# สั่งให้ DA เขียน config ของ user นั้นใหม่ให้รับไฟล์ cust_nginx
echo 'action=rewrite&value=nginx&user=shopuser' >> /usr/local/directadmin/data/task.queue
/usr/local/directadmin/dataskq d
ชั้นที่ 4 ตอบ 403 เฉพาะหน้าส่วนตัว หน้าสินค้ายัง index ได้ครบ
ผ่านไปไม่กี่วันก็เห็นบอทอีกเจ้าวิ่งเข้า ?wc-ajax= ทั้งที่ปิดใน robots.txt ไปแล้ว ผมเลยเพิ่มชั้นสุดท้ายเป็นการ 403 ตรง ๆ เงื่อนไขคือ "เป็นบอท" และ "กำลังเข้าหน้าที่เป็นของส่วนตัว" ต้องครบสองอย่างเท่านั้น
# ยังอยู่ใน /etc/nginx/nginx-includes.conf
map $http_user_agent $is_crawler {
    default 0;
    "~*(googlebot|bingbot|baiduspider|yandex|applebot|petalbot|gptbot|claudebot|bytespider|crawler|spider)" 1;
}

map "$is_crawler:$request_uri" $bot_private_block {
    default 0;
    "~^1:/(cart|checkout|my-account)(/|\?|$)"                 1;
    "~^1:/wp-login\.php"                                       1;
    "~^1:.*[?&](add-to-cart|wc-ajax|add_to_wishlist|yith_wcwl_)=" 1;
}
# shop.example.cust_nginx — วางไว้ระดับ server ไม่ใช่ใน location
if ($bot_private_block) { return 403; }
limit_req zone=addtocart burst=5 nodelay;
ที่ต้องวางระดับ server เพราะ if กับ return ทำงานใน rewrite phase คือทำงานก่อนจะเลือก location และก่อน proxy_pass ถ้าไปวางใน location ที่ proxy ต่อไปหา Apache มันจะยิงไม่ทัน
ผมเขียนชื่อบอทเต็มทุกตัวใน map ตั้งใจครับ ถ้าใส่ bot ลอย ๆ มันจะ match user-agent ของมือถือบางรุ่นที่มีคำนี้อยู่ในชื่อ (เช่นยี่ห้อที่ลงท้ายด้วย bot) ผลคือลูกค้าจริงที่ถือเครื่องรุ่นนั้นเปิดตะกร้าไม่ได้ทั้งร้าน แล้วอาการแบบนี้จะไม่มีใครแจ้งเข้ามาให้ตรง ๆ ด้วย เขาจะเลิกซื้อเฉย ๆ
ผลที่ต้องได้หลังปิดครบสี่ชั้น แยกเป็นสองฝั่งให้ชัด
เมื่อ UA เป็นบอท
/cart/ · /checkout/ · /my-account/ · /wp-login.php · ?add-to-cart= · ?wc-ajax= · wishlist ทั้งหมด
ทั้งบอทและคนจริง
/ · /shop/ · หน้าสินค้าทุกใบ · /sitemap.xml · /feed/ และ UA ของเบราว์เซอร์จริงต้องได้ 200 ทุกเส้นทางรวมถึงตะกร้า
กับดักตอนทดสอบ ที่ทำผมเสียเวลาไปหลายรอบ
ตรงนี้คือส่วนที่ผมอยากเล่าที่สุดในบทความนี้ เพราะมันกินเวลาผมไปหลายรอบกว่าจะรู้ตัว
หลังใส่ config เสร็จผมทดสอบด้วยวิธีที่ปกติใช้ได้เสมอ คือ curl --resolve ชี้โดเมนไปที่ 127.0.0.1 เพื่อไม่ต้องออกอินเทอร์เน็ต ผลคือได้ 200 หมดทุกอัน ทั้งที่ nginx -T ก็เห็น directive อยู่ครบ ผมลองใส่ add_header สำหรับ debug เข้าไปก็ไม่โผล่ ลองเพิ่ม location ทดสอบเข้าไปก็ได้หน้า 404 ของ WordPress กลับมาแทน ถึงตรงนั้นผมเกือบสรุปว่า .cust_nginx ใช้ไม่ได้แล้ว
สาเหตุคือ server block ที่ DirectAdmin สร้างให้แต่ละโดเมนนั้น listen อยู่บนไอพีสาธารณะของเครื่อง ไม่ใช่ loopback พอเรายิงเข้า 127.0.0.1 คำขอเลยไปตกที่ server block ตัวอื่นซึ่งไม่มี directive ของโดเมนเราอยู่เลย ได้ 200 กลับมาแบบไม่ผิดอะไรสักอย่าง มันแค่ไม่ใช่บล็อกที่เราแก้
ทดสอบ nginx ระดับโดเมนบน DirectAdmin ต้อง --resolve ไปที่ไอพีสาธารณะจริงของเครื่องเท่านั้น ถ้าจำเป็นต้องยิงจากตัวเครื่องเองก็ยังใช้ไอพีสาธารณะของมันได้ตามปกติ อย่าใช้ 127.0.0.1 เด็ดขาด เห็น 200 แล้วจะหลงทางยาว
ชุดทดสอบที่ถูกต้อง ผมใช้แบบนี้ ยิงขนานกัน 20 อันเพื่อดูว่า rate limit ทำงานจริงไหม
IP=203.0.113.10          # ไอพีสาธารณะของเซิร์ฟเวอร์ ไม่ใช่ 127.0.0.1
D=shop.example

# 1) add-to-cart 20 อันขนานกัน -> ต้องมีตัวที่โดน 429
for i in $(seq 1 20); do
  curl -s -o /dev/null -w "%{http_code}\n" --resolve $D:443:$IP \
    "https://$D/?add-to-cart=1234" &
done; wait | sort | uniq -c

# 2) หน้าแรก 20 อันขนานกัน -> ต้อง 200 ทั้งหมด ห้ามโดนหางเลข
for i in $(seq 1 20); do
  curl -s -o /dev/null -w "%{http_code}\n" --resolve $D:443:$IP "https://$D/" &
done; wait | sort | uniq -c

# 3) เทสต์ฝั่งบอท -> ต้อง 403 เฉพาะหน้าส่วนตัว
for p in /cart/ /checkout/ /my-account/ "/?wc-ajax=get_refreshed_fragments"; do
  printf '%s -> ' "$p"
  curl -s -o /dev/null -w "%{http_code}\n" -A "Googlebot/2.1" \
    --resolve $D:443:$IP "https://$D$p"
done

# 4) เทสต์ว่าหน้าที่ต้อง index ยังเข้าได้ -> ต้อง 200 ทั้งหมด
for p in / /shop/ /sitemap.xml /feed/; do
  printf '%s -> ' "$p"
  curl -s -o /dev/null -w "%{http_code}\n" -A "Googlebot/2.1" \
    --resolve $D:443:$IP "https://$D$p"
done
ผลจริงที่ได้จากรอบ 20 ขนาน
ตัวเลข 429 ตรงนี้สำคัญกว่าที่คิดครับ เพราะ 429 คือคำตอบที่ nginx ตอบเองโดยไม่ต้องปลุก PHP-FPM เลย ต้นทุนต่อ request เหลือแทบเป็นศูนย์ ต่างจากตอนก่อนแก้ที่ทุก request ต้องบูต WooCommerce เต็มก้อน
ปิดท้ายที่ฝั่ง PHP-FPM และบทเรียนที่ผมพลาดเอง
อีกจุดที่คนชอบทำผิดคือพอเห็น pool เต็มแล้วรีบเพิ่ม pm.max_children ส่วนตัวผมมองว่าบน shared host การจำกัดจำนวนลูกคือเกราะป้องกันเว็บข้างเคียง ไม่ใช่ปัญหา เพิ่มไปมีแต่จะพากันจมทั้งเครื่อง ผมเลยคง 10 ไว้เท่าเดิม แล้วเติมแค่ timeout กันงานค้างแทน
; /usr/local/directadmin/data/users/shopuser/php/php-fpm84.conf
[shopuser]
pm = ondemand
pm.max_children = 10
pm.max_requests = 500
request_terminate_timeout = 60s
systemctl reload php-fpm84
ทั้ง php-fpm<ver>.conf ของ user และไฟล์ config ฝั่งแคชที่ DA จัดการ เป็นไฟล์ที่ระบบอาจเขียนใหม่ตอนมีการแก้ค่าจากหน้าแผงควบคุม ผมเลยเก็บสำเนาต้นฉบับของทุกไฟล์ที่แก้ไว้นอกเครื่อง แล้วมีสคริปต์ไล่เช็คเป็นระยะว่าค่ายังอยู่ครบไหม ส่วนของที่ต้องรอดแน่ ๆ ให้ย้ายไปอยู่ใน nginx-includes.conf กับ .cust_nginx แทน สองตัวนี้ DA ไม่ยุ่งด้วย
ตอนแก้เคสนี้ผมเห็นว่า object cache ของร้านเต็มอยู่ตลอด เลยขยายเพดานหน่วยความจำของแคชขึ้นไปหลายเท่าเพื่อลดภาระ MySQL ผลคือแก้ปัญหาตรงหน้าได้จริง แต่อีกไม่กี่สัปดาห์ถัดมาแคชตัวนั้นโตทะลุเพดานที่ระดับ cgroup ของ service กำหนดไว้ แล้วโดน kernel เบรกจนเว็บค้างตอนโพสต์สินค้า ตัวเลขข้างในแอปต้องต่ำกว่ากำแพงข้างนอกเสมอ ผมสรุปเป็นกฎ 80% แล้วเขียนแยกไว้อีกบทความหนึ่งครับ
สรุปลำดับที่ผมใช้กับเคสแบบนี้ ไล่จากถูกไปแพง ทำทีละชั้นแล้ววัดผลก่อนขึ้นชั้นถัดไปเสมอ
- อ่าน log ให้ได้ตัวจริงก่อน ว่าเป็นบอทตัวไหน วิ่งเข้า path อะไร กี่ครั้ง อย่าเดาจากเมลเตือนของระบบ เพราะมันชี้แค่ปลายเหตุว่า PHP กับ MySQL กินเครื่อง
- robots.txt ปิดเฉพาะหน้าส่วนตัว ห้ามเผลอปิดหน้าสินค้าหรือหมวดหมู่ ทำแล้วรอดูรอบเก็บข้อมูลถัดไป
- ใส่ rel=nofollow ที่ลิงก์ตะกร้าในหน้ารายการสินค้าด้วย mu-plugin ตัดปัญหาที่ต้นทางว่าทำไมบอทถึงรู้จักลิงก์พวกนี้
- nginx limit_req แบบ map key ว่าง เพื่อให้มีผลเฉพาะโดเมนและเฉพาะ path ที่ต้องการ ไม่กระทบเว็บอื่นบนเครื่องเดียวกัน
- 403 เฉพาะเงื่อนไข บอท + หน้าส่วนตัว เท่านั้น แล้วทดสอบสองฝั่งเสมอ คือทั้งฝั่งที่ต้องโดนบล็อกและฝั่งที่ห้ามโดนบล็อก
- ทดสอบผ่านไอพีสาธารณะของเครื่อง ไม่ใช่ loopback แล้วเก็บชุดคำสั่งทดสอบไว้ใช้ซ้ำตอนมีคน rewrite config ทีหลัง
ที่อยากฝากไว้คือ อย่าเหมาว่าโหลดพุ่งเท่ากับโดนโจมตี เคสนี้ถ้าผมสั่งบล็อกทั้ง IP ไปตั้งแต่แรกก็จบเร็วเหมือนกัน แต่จะเสียโอกาสที่เนื้อหาสินค้าของร้านจะถูกเก็บไปใช้ตอบคำถามคนบนเครื่องมือ AI ด้วย ผมเลยเลือกทางที่ปิดเฉพาะประตูที่ไม่มีใครควรเดินเข้า แล้วเปิดหน้าร้านทิ้งไว้ให้ทุกคนตามเดิม
ใครจะเอาโครงนี้ไปใช้ ปรับ rate กับรายชื่อ UA ตามหน้างานได้ตามสะดวกครับ ถ้าร้านไหนใช้ปลั๊กอินแคชคนละตัวกัน path ที่ต้องปิดอาจไม่เหมือนกันเป๊ะ ให้ยึดหลักเดียวกันคือ "หน้าที่ผูกกับ session รายคน = ไม่ต้อง index" ตรงไหนผมอธิบายตกหล่นหรือพิมพ์ผิด เดี๋ยวกลับมาแก้เพิ่มให้ภายหลังครับ </content> </invoke>
อยากให้เราทำให้ไหม?
ให้เราช่วยติดตั้ง ตั้งค่า ย้ายระบบ หรือแก้ปัญหาเซิร์ฟเวอร์ เพื่อให้คุณมีเวลาไปทำงานที่สำคัญกว่า
เคยเจองานแบบนี้ไหม? ติดตรงไหน?
มาแลกวิธีกันต่อในบอร์ด LinuxThai
ความคิดเห็น 0
ยังไม่มีความคิดเห็น — เป็นคนแรกเลย