แชทบอทตอบช้าเพราะยัดความรู้ทั้งเว็บใน prompt: ดัชนีที่อัปเดตทีละแถว
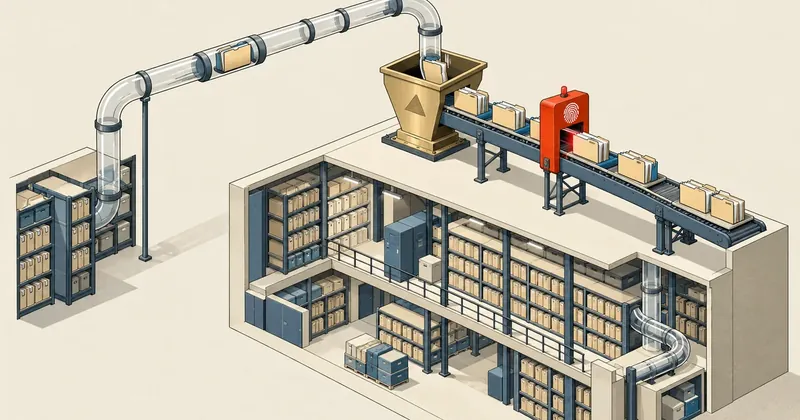
prompt ที่ใหญ่เกินไปแพงทุกเทิร์น ส่วน prompt ที่ว่างเปล่าแล้วให้โมเดลค้นเองก็ช้าเพราะต้องเรียก tool ซ้ำ ทางที่ใช้ได้จริงคือแยกสิ่งที่ต้องรู้ทุกครั้งออกจากสิ่งที่ค้นเมื่อต้องใช้ แล้วใช้ hash คุมไม่ให้แคชพังโดยไม่จำเป็น
สรุปใน 1 นาที
- อาการ/ปัญหา
- แชทบอทแบกเนื้อหาทั้งเว็บใน prompt ราว 110k โทเคน แต่ยังต้องเรียก tool ค้นหลายรอบ
- ใครควรอ่าน
- คนทำแชทบอท LLM ให้เว็บที่มีเนื้อหาเยอะ
- ทางแก้แบบสั้น
- ทำตารางดัชนีความรู้ที่อัปเดตทีละแถวจาก model event เขียนเมื่อ hash เปลี่ยน แยกส่วน hot ที่เข้า prompt เสมอออกจากส่วนที่ค้นเมื่อจำเป็น
พอดีแชทบอทที่ตอบลูกค้าให้เว็บลูกค้ารายหนึ่งของผมตอบช้าขึ้นเรื่อย ๆ ผมเลยไล่ดูว่าแต่ละคำถามมันกินอะไรไปบ้าง เจอว่ารุ่นแรกผมยัดเนื้อหาของเว็บทั้งหมดลงใน prompt ทั้งหน้าบริการ บทความ ข้อมูลทีมงาน คำตอบสำเร็จรูป และแนวทางการตอบ รวมแล้วราว 110k โทเคนต่อเทิร์น พอเนื้อหาในเว็บถูกแก้ แคชของ prompt ก็แตกทั้งก้อน ทั้งแพงทั้งช้า ผมลองแก้ด้วยการกลับด้าน ให้ prompt เบาแล้วให้โมเดลเรียก tool ค้นเอง ก็ได้ปัญหาใหม่คือต้องเรียกค้นหลายรอบกว่าจะได้คำตอบ บทความนี้เล่าตอนที่ผมเลือกทางกลางแล้วได้ผล
เวลากับจำนวนโทเคนในบทความนี้วัดบนคำถามทดสอบ 8 ข้อกับเว็บหนึ่งเว็บ และตัวเลขก่อนแก้มาจากโน้ตที่ผมจดไว้ตอนนั้น ผมตรวจย้อนหลังไม่ได้แล้ว ให้ใช้เป็นลำดับขนาดไว้เทียบแนวคิด ไม่ใช่ค่าที่สัญญาได้ว่าเว็บของคุณจะออกมาเท่ากัน
ปัญหา ยัดทั้งเว็บกับค้นอย่างเดียว ไม่เวิร์กทั้งคู่
เริ่มจากเลขที่ผมจดไว้ รุ่นที่ยัดทั้งเว็บกับรุ่นที่ผมปรับแล้ววัดบนชุดคำถามเดียวกัน
ที่ผมเห็นชัดคือเวลาไม่ได้หมดไปกับการเขียนคำตอบอย่างเดียว ก่อนแก้ คำถามหนึ่งข้อต้องเรียก tool ค้นราว 10 ครั้ง ทั้งที่ prompt ใหญ่ขนาดนั้นแล้ว เพราะโมเดลไม่แน่ใจว่าข้อมูลที่ต้องการอยู่ตรงไหนของก้อนใหญ่ เลยค้นยืนยันซ้ำ ส่วนหลังแก้เหลือ 1 ครั้งต่อคำถาม
prompt ใหญ่ แคชแตกง่าย
โมเดลเห็นทุกอย่างในครั้งเดียว แต่ทุกครั้งที่เจ้าของเว็บแก้คำเดียวในหน้าใดหน้าหนึ่ง ข้อความ prompt ก็เปลี่ยน แคชของ prompt ใช้ต่อไม่ได้ ค่าใช้จ่ายกับเวลาก็กลับมาเต็มจำนวนในเทิร์นถัดไป
prompt เบา แต่ต้องเรียกหลายรอบ
ไม่มีอะไรให้แคชแตก แต่โมเดลต้องคิดคำค้นเอง เรียกผลลัพธ์กลับมาอ่าน แล้วบางทีค้นรอบสองรอบสามเพราะคำแรกไม่ตรง ทุกรอบคือหนึ่งรอบเดินทางไปกลับ
ส่วนตัวผมเลือกทางผสม แยกความรู้เป็นสองกอง กองที่ลูกค้าถามแทบทุกวันกับกองที่ถามนาน ๆ ครั้ง กองแรกใส่ prompt ไว้เลย กองหลังให้ค้นเมื่อจำเป็น ตามใจชอบถ้าเว็บของใครเล็กพอที่จะยัดทั้งก้อนได้ แต่ของผมไม่เล็กขนาดนั้น
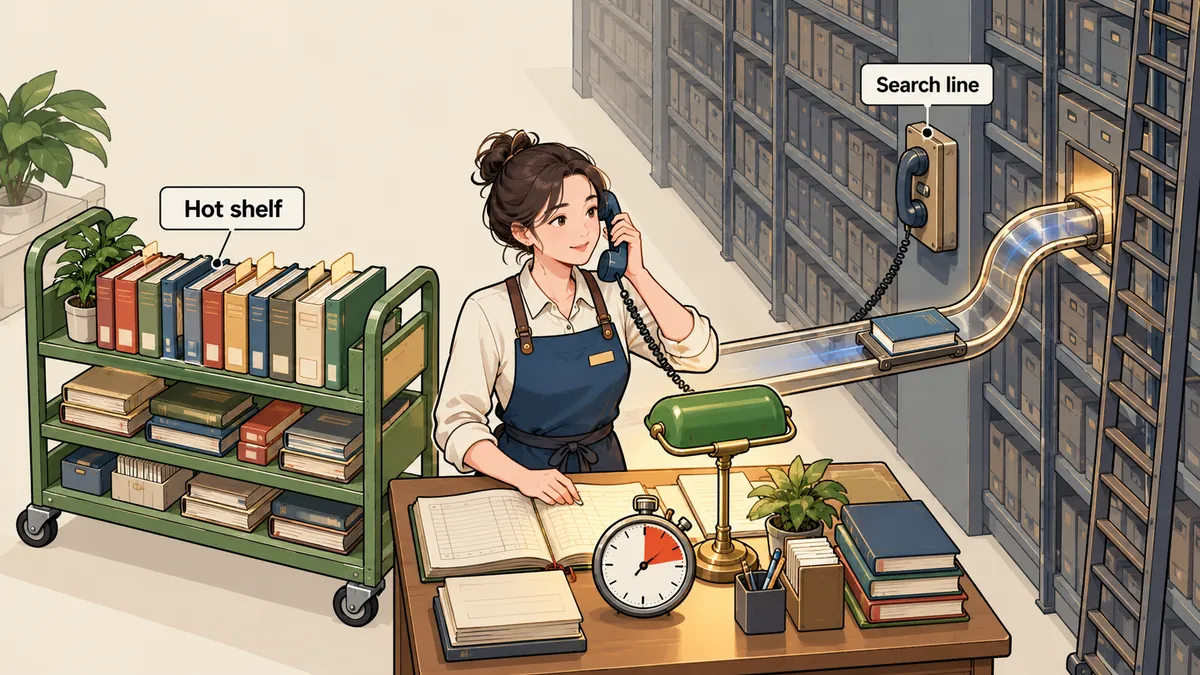
ตารางดัชนี หนึ่งแถวต่อเนื้อหาหนึ่งชิ้นต่อหนึ่งภาษา
ผมทำตาราง knowledge_index แถวหนึ่งแทนเนื้อหาหนึ่งชิ้นในภาษาหนึ่ง คีย์ไม่ซ้ำคือ source_type กับ source_id และ locale เก็บข้อความที่ประกอบเสร็จแล้วพร้อมเสิร์ฟเข้า prompt และ hash แบบ md5 ของข้อมูลที่ประกอบ ชนิดเนื้อหาแต่ละแบบ (สินค้าหลัก บริการ บทความ ทีมงาน คำตอบสำเร็จรูป แนวทางตอบ ข้อมูลทั่วไปของเว็บ) มีคลาส Mapper ของตัวเองหนึ่งตัว ทำหน้าที่แปลงแถวจากตารางต้นทางให้เป็นข้อความหน้าตาเดียวกันหมด
CREATE TABLE knowledge_index (
  id           BIGINT UNSIGNED AUTO_INCREMENT PRIMARY KEY,
  source_type  VARCHAR(40)  NOT NULL,
  source_id    BIGINT       NOT NULL,
  locale       VARCHAR(8)   NOT NULL,
  title        VARCHAR(255) NOT NULL,
  body         MEDIUMTEXT   NOT NULL,
  is_hot       TINYINT(1)   NOT NULL DEFAULT 0,
  content_hash CHAR(32)     NOT NULL,
  updated_at   TIMESTAMP    NULL,
  UNIQUE KEY uq_source (source_type, source_id, locale)
);
กฎข้อเดียวที่ทำให้แคชนิ่งคือ เขียนแถวก็ต่อเมื่อ hash ต่างจากของเดิม บันทึกซ้ำโดยไม่มีอะไรเปลี่ยนจริง (เจ้าของเว็บกดบันทึกโดยไม่ได้แก้ หรือคอลัมน์ฝั่งแอดมินอย่างเวลาแก้ไขล่าสุดขยับ) จะไม่แตะแถวเลย ตัว version ของดัชนีเลยไม่ขยับ
public static function upsert(string $type, int $id, string $locale, array $row): void
{
    $hash = md5(json_encode($row, JSON_UNESCAPED_UNICODE));
    $key  = ['source_type' => $type, 'source_id' => $id, 'locale' => $locale];

    $old = DB::table('knowledge_index')->where($key)->value('content_hash');
    if ($old === $hash) {
        return;                       // ไม่มีอะไรเปลี่ยนจริง ไม่แตะแถว ไม่ขยับ version
    }

    DB::table('knowledge_index')->updateOrInsert($key, [
        'title'        => $row['title'],
        'body'         => $row['body'],
        'is_hot'       => $row['is_hot'] ? 1 : 0,
        'content_hash' => $hash,
        'updated_at'   => now(),
    ]);
}

public static function version(): string
{
    $all = DB::table('knowledge_index')
        ->orderBy('source_type')->orderBy('source_id')->orderBy('locale')
        ->pluck('content_hash')->implode('');
    return dechex(crc32($all));       // CRC32 ของ hash ทุกแถวต่อกัน
}
ค่า version ตัวนี้แหละที่ผมใช้เป็น ETag ของ endpoint และเป็นตัวบอกว่า prompt ก้อน hot เปลี่ยนหรือยัง ถ้าไม่มีแถวไหนเปลี่ยน hash version ก็เท่าเดิม ข้อความ prompt ก็เท่าเดิมทุกตัวอักษร แคชของ prompt เลยใช้ต่อได้
อัปเดตจาก model event ทีละแถว ไม่ rebuild ทั้งก้อน
ตัวกระตุ้นคือ model event saved กับ deleted ของแต่ละโมเดลต้นทาง ลงทะเบียนไว้ตอนบูตแอปในที่เดียว พอเจ้าของเว็บแก้บทความหนึ่งชิ้น event ยิง Mapper ของบทความ ประกอบข้อความใหม่ ผ่าน upsert ด้านบน เขียนแถวเดียวถ้า hash ต่าง ลบแถวถ้าต้นทางถูกลบ ไม่มีการไล่ประกอบทั้งเว็บใหม่เลย
foreach ($mappers as $modelClass => $mapper) {
    $modelClass::saved(fn ($m) => KnowledgeIndex::sync($mapper, $m));
    $modelClass::deleted(fn ($m) => KnowledgeIndex::forget($mapper, $m));
}
แต่ event ไม่ได้ครอบคลุมทุกเส้นทาง SQL ก้อนใหญ่ที่รันตรง ๆ นำเข้าข้อมูลจำนวนมาก หรือการแก้ไขที่ข้ามตัวโมเดล ไม่ยิง event ผมเลยทำคำสั่ง artisan สำหรับ backfill ไว้อีกทาง รันซ้ำกี่รอบก็ได้ เพราะมันใช้ upsert ตัวเดียวกัน เขียนเฉพาะแถวที่ hash เปลี่ยน และลบแถวที่ต้นทางหายไปแล้ว
# ชื่อคำสั่งเป็นชื่อสมมติ
php artisan knowledge:index                       # ซ่อมทั้งดัชนี เขียนเฉพาะแถวที่ต่าง
php artisan knowledge:index --only=article        # เฉพาะชนิดเดียว
php artisan knowledge:index --show=hot            # ดูข้อความส่วน hot ที่จะเข้า prompt
php artisan knowledge:index --search="ราคา ค่าส่ง"  # ลองค้นเหมือนที่บอทค้น
ผมใช้ --show=hot บ่อยที่สุด เพราะมันบอกตรง ๆ ว่าโมเดลจะเห็นอะไรบ้าง ถ้าเจ้าของเว็บบ่นว่าบอทตอบไม่ตรง ผมเปิดดูก่อนเลยว่าข้อมูลนั้นอยู่ใน hot หรือเปล่า
ส่วน hot กับเพดานตัวอักษร
แถวที่ติดธง hot อยู่ใน prompt เสมอ แต่ต้องมีเพดาน ไม่งั้น hot ก็โตกลับไปเป็นการยัดทั้งเว็บอีกรอบ ผมกำหนดผ่านค่า config ตัวเดียวคือ hot_cap ปัจจุบันตั้งไว้ราว 60,000 ตัวอักษร ถ้าประกอบแล้วเกินก็ตัดตามลำดับความสำคัญ ส่วนที่เหลือไม่ได้หายไปไหน ยังค้นได้ผ่านเครื่องมือ
หลักที่ผมใช้ตัดสินว่าอะไรเป็น hot คือถามว่า ถ้าบอทไม่รู้เรื่องนี้ตั้งแต่ต้นเทิร์น คำตอบจะผิดหรือน่าเกลียดไหม เช่นข้อมูลทั่วไปของเว็บ แนวทางการตอบ คำตอบสำเร็จรูปของคำถามยอดฮิต ส่วนรายละเอียดรายชิ้นของแต่ละหน้าที่ถามกันนาน ๆ ครั้งปล่อยให้ค้น
Endpoint ที่บอทดึงไปประกอบ prompt รับ part เป็น hot, guides หรือ all กับ locale คืนข้อความสำเร็จรูปพร้อม ETag เท่ากับ index version ถ้าบอทส่ง If-None-Match มาตรงกับ version ปัจจุบันก็ตอบ 304 ไม่มี body ผมเลยให้บอทเรียกบ่อยแค่ไหนก็ได้ ไม่เปลืองทั้งแบนด์วิดท์และไม่ต้องประกอบข้อความซ้ำ
curl -si 'https://example.com/api/bot/knowledge?part=hot&locale=th' \
     -H 'If-None-Match: "a1b2c3d4"'
# HTTP/1.1 304 Not Modified      <- ไม่มีอะไรเปลี่ยน ใช้ข้อความ hot เดิมใน prompt ต่อได้
ส่วนค้น รู้ภาษาไทยและพิมพ์ผิดได้นิดหน่อย
ส่วนค้น (KnowledgeSearch) ผมเขียนให้รู้จักภาษาไทยในระดับที่ใช้งานได้ ไม่ได้ทำอะไรหรูหรา มีกลุ่มคำพ้องจาก config คำละตินจับเฉพาะ "คำเต็ม" เช่นคำว่า line ต้องไม่ไปตรงกับ online รองรับพิมพ์ผิดของคำละตินด้วยระยะ levenshtein ไม่เกิน 2 กับคำพ้องที่ตั้งไว้ ถ่วงน้ำหนักแบบ idf คือคำหายากหนักกว่าคำที่เจอทุกที่ ชื่อเรื่องคูณ 1.6 และแถวที่มีครบทุกกลุ่มคำที่ต้องการขึ้นก่อนแถวที่มีบางคำ ส่วนเรื่องเอนจินค้นไทยโดยเฉพาะ ผมเขียนแยกไว้แล้วใน ตอนค้นภาษาไทยด้วย FTS5 trigram ตรงนี้เลยไม่ลงรายละเอียดซ้ำ
Presearch ค้นให้ก่อนโมเดลเริ่ม แต่ห้ามบล็อกบอท
ก่อนแก้ ปัญหาหลักของเวลาคือโมเดลต้องเรียก tool ค้นเอง ผมเลยให้ตัวบอทเอาข้อความของลูกค้าไปค้นเองก่อนที่จะเรียกโมเดล แล้วแทรกผลอันดับต้น ๆ เข้าไปในเทิร์นเลย โมเดลส่วนใหญ่ได้ข้อมูลที่ต้องการตั้งแต่ต้นโดยไม่ต้องเรียก tool ซึ่งนี่คือที่มาของตัวเลข 10 ครั้งเหลือ 1 ครั้ง
ข้อบังคับข้อเดียวคือ presearch ต้องมี timeout เข้ม ผมตั้งไว้ 1.5 วินาที ถ้าช้ากว่านั้นหรือล้ม ก็ข้ามไปเลย ไม่ใส่อะไร โมเดลยังมี tool ค้นของตัวเองสำรองอยู่ ลูกค้าไม่เห็นความแตกต่างอะไรนอกจากช้าลงนิดหน่อยในเทิร์นนั้น
PRESEARCH_TIMEOUT = 1.5   # วินาที

def presearch_block(user_text: str) -> str:
    try:
        r = requests.get(SEARCH_URL, params={"q": user_text, "limit": 5},
                         timeout=PRESEARCH_TIMEOUT)
        r.raise_for_status()
        return format_hits(r.json())      # ผลอันดับต้น ๆ เป็นข้อความสั้น ๆ
    except Exception:
        return ""                         # ช้าหรือล้ม ข้ามไป ห้ามให้บอทต้องรอ
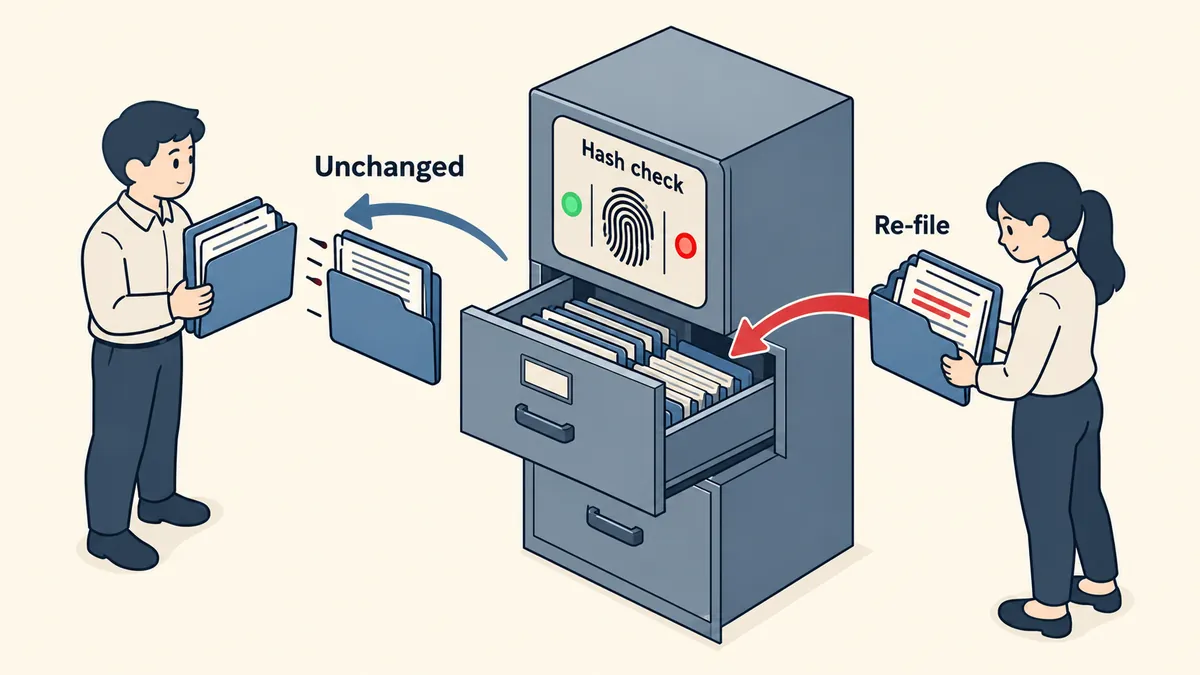
วิธีเช็กว่าแคชนิ่งจริง ไม่ใช่แค่เชื่อว่านิ่ง
เรื่องที่ผมระวังที่สุดของระบบนี้คือมันพังแบบเงียบ ๆ ได้ ถ้า hash คำนวณจากข้อมูลที่มีค่าแกว่งโดยไม่ได้ตั้งใจ (เช่นเวลาปัจจุบัน หรือลำดับของรายการที่ไม่แน่นอน) แถวจะถูกเขียนใหม่ทุกครั้ง version ขยับทุกครั้ง และแคชของ prompt แตกทุกเทิร์นโดยที่ไม่มี error ให้เห็นสักบรรทัด ผมเลยมีเช็กลิสต์สั้น ๆ ที่รันหลังเพิ่ม Mapper ตัวใหม่ทุกครั้ง
- เรียก endpoint ส่วน hot สองครั้งติดกันโดยไม่แก้อะไร ETag ต้องเท่ากัน และครั้งที่สองต้องได้ 304
- เปิดหน้าแอดมินของเนื้อหาชิ้นหนึ่ง กดบันทึกโดยไม่แก้สักตัวอักษร แล้วเรียกซ้ำ ETag ต้องยังเท่าเดิม
- แก้คำเดียวในเนื้อหาชิ้นนั้นแล้วบันทึก ETag ต้องเปลี่ยน และเปลี่ยนแค่แถวเดียว
- รัน backfill ทั้งชุดบนข้อมูลที่ไม่ได้แก้ ต้องเขียนศูนย์แถว
H1=$(curl -sI 'https://example.com/api/bot/knowledge?part=hot&locale=th' | grep -i '^etag')
php artisan knowledge:index            # ต้องไม่เขียนแถวไหนเลย
H2=$(curl -sI 'https://example.com/api/bot/knowledge?part=hot&locale=th' | grep -i '^etag')
[ "$H1" = "$H2" ] && echo "[OK] version นิ่ง" || echo "[ERR] version ขยับโดยไม่มีอะไรเปลี่ยน"
ถ้าข้อสามผ่านแต่ข้อสองไม่ผ่าน แปลว่าใน Mapper มีค่าที่ไม่ควรอยู่ในข้อความที่ประกอบ ผมไล่ดูทีละฟิลด์ว่าตัวไหนแกว่ง ส่วนใหญ่เป็นเวลาหรือลำดับที่ไม่ได้ sort ทางแก้คือตัดฟิลด์นั้นออกหรือเรียงให้แน่นอนก่อนประกอบ อีกเรื่องที่ควรรู้คือการแยก hot ออกจากส่วนที่เหลือไม่ได้ฉลาดเอง ผมตั้งธง hot ด้วยมือตามชนิดเนื้อหา และเปิดดูผลด้วย --show=hot เป็นระยะ เพราะเนื้อหาที่ลูกค้าถามบ่อยเปลี่ยนไปตามช่วงเวลา สิ่งที่เคย hot อาจไม่ใช่ hot อีกต่อไป และสิ่งที่ไม่เคยถามอาจกลายเป็นคำถามประจำสัปดาห์นี้
ข้อคิดที่ผมเอาไปใช้กับงานอื่นต่อ
- แยก "ต้องรู้ทุกครั้ง" ออกจาก "ค้นเมื่อจำเป็น" ด้วยเพดานตัวอักษรที่เป็นตัวเลขชัด ๆ ไม่ใช่ความรู้สึก
- ใช้ hash คุมการเขียน แถวที่ไม่ได้เปลี่ยนจริงห้ามขยับ ไม่งั้นแคชของ prompt พังโดยที่ไม่มีใครแก้อะไรเลย
- ให้ endpoint ตอบ ETag กับ 304 จะได้เรียกบ่อยแค่ไหนก็ไม่เปลืองสักบาท
- presearch ต้องมี timeout เข้ม และต้องล้มแบบเงียบ ๆ ห้ามบล็อกบอท
- ต้องมี pass backfill ที่รันซ้ำได้เสมอ เพราะ event ไม่ครบทุกเส้นทาง
อย่าเอาบทสนทนาของลูกค้าจริงมาเป็นตัวอย่างหรือเป็น seed ของระบบ ผมใช้ตัวอย่างสมมติล้วน ๆ เช่น สินค้า A ราคา X เพราะข้อมูลสนทนาเป็นข้อมูลส่วนตัวของคนที่ไม่รู้ว่าถูกเอามาเป็นตัวอย่าง
สรุป
สรุปตามที่ผมทำจริงคือ อย่ายัดทั้งเว็บและอย่าค้นอย่างเดียว ให้แยกสองกองด้วยเพดาน คุมการเขียนด้วย hash และให้บอทค้นล่วงหน้าแบบมี timeout ตัวเลขของผมคือเวลาจาก 10.5 วินาทีเหลือ 6.1 วินาที จำนวน tool call จาก 10 ครั้งเหลือ 1 ครั้ง และ prompt จาก 110k เหลือ 77k โทเคน แต่ย้ำอีกครั้งว่าเป็นผลบนคำถามทดสอบ 8 ข้อ เว็บอื่นที่เนื้อหาเยอะหรือน้อยกว่านี้ เพดาน hot ก็ต้องปรับตามกำลังเงินและความอดทนของลูกค้าเอง ตรงไหนที่ผมเขียนตกหรือตัวเลขไม่ตรงกับเว็บของใคร เดี๋ยวกลับมาแก้เพิ่มให้ภายหลังครับ
อยากให้เราทำให้ไหม?
ให้เราช่วยติดตั้ง ตั้งค่า ย้ายระบบ หรือแก้ปัญหาเซิร์ฟเวอร์ เพื่อให้คุณมีเวลาไปทำงานที่สำคัญกว่า
เคยเจองานแบบนี้ไหม? ติดตรงไหน?
มาแลกวิธีกันต่อในบอร์ด LinuxThai
ความคิดเห็น 0
ยังไม่มีความคิดเห็น — เป็นคนแรกเลย