backup รันสำเร็จทุกคืน แต่ของนอกเครื่องไม่มีเลย 3 สัปดาห์
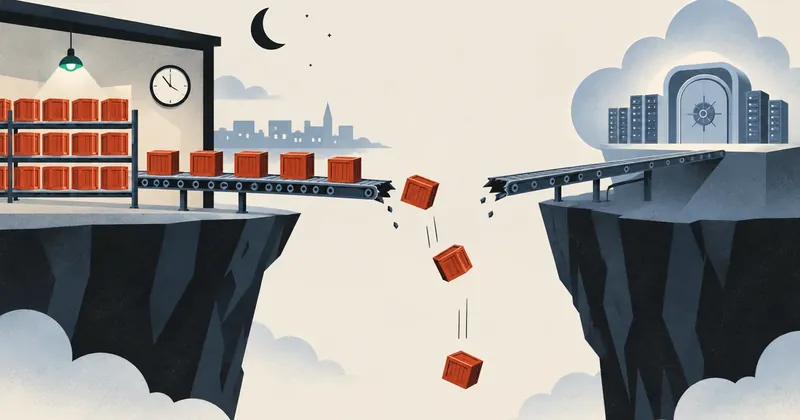
backup ที่ล้มแล้วส่งเสียง ยังนับว่าเป็น backup ที่ใช้ได้ ส่วน backup ที่ล้มแล้วเงียบคือของปลอมที่เราจ่ายค่าดิสก์ให้มันทุกเดือนโดยไม่รู้ตัว
สรุปใน 1 นาที
- อาการ/ปัญหา
- backup นอกเครื่องไม่ขยับมา 3 สัปดาห์ ทั้งที่ cron รันครบและ log บอกว่าเสร็จ
- ใครควรอ่าน
- ผู้ดูแลเซิร์ฟเวอร์ที่ส่ง backup ไป object storage ด้วย rclone
- ทางแก้แบบสั้น
- เลิกทิ้ง error ด้วย 2>/dev/null ให้ healthcheck ตรวจปลายทางจริง ไม่ใช่แค่ไฟล์ในเครื่อง และให้ปลายทางเป็นตัวชี้ว่าสำเร็จ
พอดีต้องไปเก็บ snapshot ของเครื่องเซิร์ฟเวอร์ตัวหนึ่งลงเครื่องตัวเอง เผื่อไว้ว่าจะต้องสร้างใหม่ ตอนไล่ดูว่าไฟล์ล่าสุดบนที่เก็บนอกเครื่องอยู่วันไหน ผมเจอว่าโฟลเดอร์ของเดือนนั้นมีไฟล์อยู่แค่ชุดเดียว ทั้งที่ cron ตั้งให้อัปทุกคืนมาตั้งนาน ไล่ย้อนกลับไปดูอีกทีเลยรู้ว่าการอัปขึ้นที่เก็บนอกเครื่องล้มทุกไฟล์ติดกันสามสัปดาห์ โดยไม่มีใครในระบบส่งเสียงอะไรออกมาเลยสักครั้ง
ที่เจ็บกว่าคือของในเครื่องตั้ง rotate ไว้ 14 วัน แปลว่าตอนที่ผมมาเห็น ชุดของแปดคืนแรกที่อัปไม่ขึ้นนั้นถูกลบไปจากเครื่องเรียบร้อยแล้วด้วย ไม่เหลือทั้งสองที่ บทความนี้ผมเลยเขียนเป็นการชันสูตรครับ ว่าระบบที่ดูครบดีทุกอย่างมันหลุดตรงไหนได้บ้าง และแก้ยังไงให้ครั้งหน้ามันร้องก่อนที่ของจะหาย
ชื่อผู้ใช้ พาธ ชื่อ bucket และหมายเลขไอพีในบทความเป็นค่าตัวอย่างทั้งหมด ส่วนโครงสร้างและอาการเป็นของจริง
หน้าตาของระบบที่ควรจะไว้ใจได้
โครงมันตรงไปตรงมามาก และผมยืนยันว่าโครงไม่ได้ผิดอะไรเลย สคริปต์ตัวเดียวรันตอนตีสอง ออกไฟล์สามก้อน แล้วผลักขึ้นที่เก็บ object storage ปลายทาง
สามไฟล์ที่ออกมาคือ dump ฐานข้อมูลทั้งก้อน, tar ของโฟลเดอร์ความลับกับไฟล์ .env, และ tar ของ git bare repo กับโฟลเดอร์ที่ไม่ได้อยู่ใน git จุดที่ผมชอบในดีไซน์นี้คือเอกสารของลูกค้าถูกเก็บเป็น blob อยู่ในฐานข้อมูล ไม่ได้กระจายเป็นไฟล์ แปลว่า dump ฐานข้อมูลก้อนเดียวครอบคลุมตู้เอกสารครบ ไม่ต้องไล่ backup ไฟล์แยกอีกชั้น
# cron ของ user (3 บรรทัด ไม่มี cron ของ root เลย)
0 2 * * *   /opt/appsrv/app/scripts/backup-all.sh   >> /opt/appsrv/.private/backups/backup.log 2>&1
*/5 * * * * /opt/appsrv/app/scripts/healthcheck.sh  >> /opt/appsrv/.private/backups/health.log 2>&1
* * * * *   cd /opt/appsrv/app && /usr/bin/php artisan schedule:run >> /dev/null 2>&1
มี healthcheck รันทุกห้านาที เช็กหกอย่าง แล้วยิงเมลแจ้งเตือนถ้าเจอผิด บนกระดาษถือว่าเรียบร้อยกว่าเครื่องส่วนใหญ่ที่ผมเคยเจอด้วยซ้ำ แต่ของก็ยังหายไปได้อยู่ดี
รูที่หนึ่ง — 2>/dev/null ทิ้งข้อความที่จำเป็นที่สุด
บรรทัดที่เป็นต้นเหตุจริง ๆ สั้นมากครับ
# สาระของบรรทัดที่ผิด
if rclone copy "$f" "r2:app-backup/$YEAR/$MONTH/" 2>/dev/null; then
    log "uploaded $(basename "$f")"
else
    log "upload failed: $(basename "$f")"
fi
เจตนาของคนเขียน (ซึ่งก็คือตัวผมเองในอีกวันหนึ่ง) คืออยากให้ log สะอาด ไม่อยากให้ progress bar กับ warning จุกจิกของ rclone มาเปื้อนไฟล์ log ผลที่ได้คือ log บอกได้แค่คำเดียวว่า upload failed แล้วจบ ไม่มีคำใบ้เลยว่าล้มเพราะอะไร ตอนมานั่งไล่ย้อนหลังสามสัปดาห์ ทุกบรรทัดหน้าตาเหมือนกันหมด
ขาที่ต้องคุยกับของนอกเครื่องคือขาที่พังบ่อยที่สุด เพราะมันมีทั้งเน็ต ทั้ง DNS ทั้ง credential ทั้งสิทธิ์ที่ฝั่งโน้น มาเกี่ยวข้อง นี่คือขาสุดท้ายในระบบที่ควรจะโดนปิดปาก ถ้าจะกันขยะใน log ให้เก็บ stderr ลงตัวแปรแล้วพิมพ์เฉพาะตอนล้ม อย่ายิงทิ้งลงถังตั้งแต่แรก
รูปแบบที่ผมใช้แทนคือเก็บ stderr ไว้ก่อน แล้วค่อยตัดสินใจว่าจะพิมพ์ไหม ได้ log สะอาดตอนปกติ และได้เหตุผลเต็ม ๆ ตอนพัง
upload() {
    local f="$1" err rc
    err="$(rclone copy "$f" "r2:app-backup/$YEAR/$MONTH/" 2>&1 >/dev/null)"
    rc=$?
    if [ "$rc" -ne 0 ]; then
        log "UPLOAD FAIL rc=$rc $(basename "$f")"
        printf '%s\n' "$err" | tail -n 20 | while read -r l; do log "    | $l"; done
        return 1
    fi
    log "uploaded $(basename "$f")"
}
2>&1 >/dev/null เรียงลำดับสำคัญนะครับ ตัวแรกโยน stderr ไปทางเดียวกับ stdout ปัจจุบัน (คือ pipe ที่รับค่าเข้าตัวแปร) ตัวหลังค่อยส่ง stdout จริงไปทิ้ง ถ้าสลับที่กันจะได้ผลตรงข้ามคือกลืน stderr ไปด้วย เขียนกลับด้านแล้วดูเผิน ๆ เหมือนกันมาก
รูที่สอง — healthcheck ที่ไม่เคยแตะปลายทาง
รูที่สองเจ็บกว่ารูแรก เพราะมันคือชั้นที่เราตั้งไว้เพื่อจับเรื่องแบบนี้โดยเฉพาะ healthcheck เช็กหกอย่าง หน้าเว็บตอบ 200, ต่อฐานข้อมูลได้, สอง service ยังรัน, process ของทางเข้าจากภายนอกยังอยู่, ดิสก์ไม่เกิน 90% และข้อสุดท้าย
# ข้อที่หกของ healthcheck.sh — เช็กแค่ไฟล์ในเครื่อง
newest=$(find /opt/appsrv/.private/backups -name '*.sql.gz' -mmin -2160 | head -n1)
[ -z "$newest" ] && problem "backup ล่าสุดเก่ากว่า 36 ชั่วโมง"
เงื่อนไขนี้เป็นจริงทุกวันครับ เพราะ dump ในเครื่องมันสำเร็จจริงทุกคืน ขาที่พังคือขาถัดไปที่ไม่มีใครถามถึงเลยสักบรรทัด ระบบเฝ้าระวังทั้งชุดเลยรายงานเขียวสนิทตลอดสามสัปดาห์
ของในเครื่อง
ไฟล์ dump มีอยู่ อายุไม่เกิน 36 ชั่วโมง ขนาดไม่เป็นศูนย์ ทั้งหมดนี้พิสูจน์ได้แค่ว่า mysqldump กับ tar ทำงาน ซึ่งเป็นส่วนที่พังยากที่สุดในระบบอยู่แล้ว
ของที่ปลายทาง
ไม่มีใครถามว่าที่เก็บนอกเครื่องมีไฟล์ของคืนนี้ไหม ขนาดตรงกับต้นทางไหม ซึ่งคือคำถามเดียวที่ตอบว่า "ถ้าเครื่องนี้หายไปตอนนี้ เรารอดไหม"
ผมสรุปกับตัวเองว่า healthcheck ที่ตรวจแต่ฝั่งต้นทาง ไม่ใช่ healthcheck ของระบบ backup มันเป็นแค่การเช็กว่าคำสั่ง dump ยังรันอยู่ ซึ่งคนละเรื่องกับคำถามว่าเรามีของสำรองอยู่จริงหรือเปล่า
rotate 14 วันคือนาฬิกาจับเวลา ไม่ใช่นโยบายเก็บของ
ตอนออกแบบ ตัวเลข 14 วันในเครื่องกับ 90 วันบนปลายทางฟังดูสมเหตุสมผลมาก ในเครื่องเก็บพอใช้กู้เรื่องด่วน ที่เก็บนอกเครื่องเก็บยาวไว้เผื่อเรื่องใหญ่ แต่พอขาที่สองตาย ตัวเลข 14 วันเปลี่ยนความหมายทันที มันกลายเป็นนาฬิกาที่นับถอยหลังว่าเรามีเวลาเท่าไหร่ก่อนของจะหายถาวร
เอาสองเลขมาลบกันตรง ๆ เลยครับ สามสัปดาห์ลบสิบสี่วันเท่ากับหนึ่งสัปดาห์ที่ของหายทั้งสองฝั่ง ชุดของแปดคืนแรกนั้นไม่มีอยู่ที่ไหนในโลกแล้ว ส่วนตัวผมเลยเลิกมองเลข rotate ว่าเป็นเรื่องประหยัดพื้นที่ และเริ่มมองว่ามันคืองบเวลาสำหรับตรวจจับความผิดปกติ ถ้ารอบตรวจของเราช้ากว่างบเวลานี้ แปลว่าเราตั้งใจจะรู้เรื่องหลังของหายไปแล้ว
ทางแก้มีสองแบบ ทำอย่างเดียวก็พอ แต่ทำทั้งคู่ยิ่งดี อย่างแรกคือยืดของในเครื่องให้ยาวกว่ารอบที่มนุษย์จะไปเหลือบดูจริง อย่างที่สองคือทำให้การตรวจปลายทางเป็นอัตโนมัติเสียเลย ซึ่งเป็นทางที่ถูกกว่าและตรงประเด็นกว่า
แล้วมันล้มเพราะอะไรกันแน่
ตรงนี้ผมจะพูดตามที่พิสูจน์ได้นะครับ ไม่สรุปเกินหลักฐาน ตอนผมเข้าไปตรวจ rclone กลับใช้งานได้แล้วโดยที่ไม่มีใครแก้อะไรที่ตัวสคริปต์ สาเหตุที่มีน้ำหนักที่สุดคือ API token ที่เอามาทำ credential นั้นถูกผูก IP allowlist ไว้ และเครื่องนี้อยู่หลังเน็ตบ้านที่ public IP เปลี่ยนเองเป็นระยะ พอไอพีเปลี่ยน token ก็ถูกปฏิเสธทั้งชุด
อาการของเคสนี้จะออกมาเป็น error code ของฝั่งผู้ให้บริการ ไม่ใช่ error ของ S3 ธรรมดา และนี่แหละคือข้อความที่โดน 2>/dev/null กลืนไปสามสัปดาห์
# ตรวจไอพีขาออกจริงของเครื่อง แล้วเทียบกับ allowlist ของ token
curl -4 -s ifconfig.me
# 203.0.113.44

# ยืนยัน token ว่ายังใช้ได้ — account token ต้องยิงที่ /accounts/{id}/tokens/verify
curl -s -H "Authorization: Bearer $CF_TOKEN" \
     "https://api.cloudflare.com/client/v4/accounts/$ACCOUNT_ID/tokens/verify" | head -c 300
ถ้าเอา account token ไปยิงที่ /user/tokens/verify มันจะตอบ 1000 Invalid API Token ทุกครั้งไม่ว่า token จะดีหรือเสีย เพราะเส้นนั้นมีไว้สำหรับ user token คนละชนิดกัน ผมเสียเวลาไปพอสมควรกับการเชื่อคำตอบนั้นว่า token ตายแล้ว ทั้งที่ตัวมันปกติดี ต้องยิงเส้นที่มี account id เท่านั้นถึงจะได้คำตอบจริง
กับดักตอนตั้ง rclone กับ object storage แบบ S3
ระหว่างไล่เคสนี้ ผมเจอกับดักอีกสองอย่างที่ทำให้คนตั้งค่าครั้งแรกหลงทางได้ยาว เก็บไว้ตรงนี้เผื่อใครกำลังจะทำ
เรื่องแรกคือ credential ครับ ที่เก็บแบบนี้มี Access Key คู่หนึ่งให้สร้างจากหน้าเว็บ แต่คู่ที่ระบบนี้ใช้จริงไม่ใช่คู่นั้น มันคือคู่ที่ถอดมาจาก API token โดยตรง คือ Access Key เป็น id ของ token และ Secret เป็นค่า sha256 ของตัว token เอง ถ้าหยิบผิดคู่จะได้ AccessDenied ทั้ง ListBuckets และ ListObjects ซึ่งอ่านแล้วเหมือนสิทธิ์ไม่พอ ไม่เหมือนหยิบผิดกุญแจ
# ได้ secret สำหรับ S3 จากค่า token
printf '%s' "$CF_TOKEN" | sha256sum | cut -d' ' -f1
# /home/appsrv/.config/rclone/rclone.conf  (chmod 600)
[r2]
type = s3
provider = Cloudflare
access_key_id = <TOKEN_ID>
secret_access_key = <SHA256_OF_TOKEN>
endpoint = https://<ACCOUNT_ID>.r2.cloudflarestorage.com
no_check_bucket = true
เรื่องที่สองคือเวอร์ชันของ rclone ตัวที่มากับ apt บน distro เสถียรเป็นรุ่น 1.60 ซึ่งเก่าเกินไปสำหรับปลายทางตัวนี้ ผลคือได้ 501 กลับมาแบบงง ๆ ต้องโหลด binary รุ่น 1.74 ขึ้นไปมาวางเองที่ /usr/local/bin/
rclone version | head -n1
# rclone v1.74.4

which -a rclone
# /usr/local/bin/rclone
# /usr/bin/rclone        <- ตัวของ apt ที่เก่าเกิน อย่าให้ cron ไปเจอตัวนี้ก่อน
เคสคลาสสิกคือทดสอบมือแล้วผ่าน เพราะ shell ของเราเจอ /usr/local/bin/rclone ก่อน แต่พอ cron รันกลับไปโดนตัวของ apt ที่ /usr/bin/rclone แล้วได้ 501 ทุกคืน วิธีกันคืออย่าเรียกชื่อคำสั่งลอย ๆ ในสคริปต์ที่ cron รัน ให้ระบุพาธเต็มไปเลย หรือประกาศ PATH ไว้บนหัวสคริปต์
อีกจุดที่ต้องรู้คือ config ของ rclone อยู่ที่ ~/.config/rclone/rclone.conf ของ user ที่รัน cron ไม่ได้อยู่ในโฟลเดอร์โปรเจกต์ แปลว่าไฟล์นี้ไม่ได้อยู่ใน backup ที่ tar เก็บโฟลเดอร์ความลับของโปรเจกต์ ตอนกู้เครื่องใหม่ต้องสร้างเองมือ เดี๋ยวผมเขียนแยกอีกเรื่องเรื่องของที่ backup ไม่ได้เก็บ
ตรวจปลายทางแบบที่เชื่อได้จริง
ประเด็นสำคัญตอนตรวจคือต้องรู้ว่าเรากำลังอ่าน "เวลา" ตัวไหนอยู่ ผมโดนหลอกตรงนี้มารอบหนึ่ง
rclone lsl แสดง mtime ที่ติดมากับ object ซึ่งเป็น mtime ของไฟล์ต้นทางตอนอัป ส่วน LastModified ที่ได้จาก S3 API ตรง ๆ คือเวลาที่ object ถูกเขียนขึ้นจริงที่ปลายทาง สองค่านี้ต่างกัน และเวลาสืบว่า "ไฟล์นี้ขึ้นไปตอนไหนกันแน่" ต้องใช้ตัวหลัง
# ตรวจว่าไฟล์ถูกเขียนขึ้นปลายทางจริงเมื่อไหร่ (ไม่ใช่ mtime ของต้นทาง)
import boto3, os, datetime

s3 = boto3.client(
    "s3",
    endpoint_url=f"https://{os.environ['ACCOUNT_ID']}.r2.cloudflarestorage.com",
    aws_access_key_id=os.environ["S3_KEY"],
    aws_secret_access_key=os.environ["S3_SECRET"],
)

now = datetime.datetime.now(datetime.timezone.utc)
resp = s3.list_objects_v2(Bucket="app-backup", Prefix="2569/09/")
for o in sorted(resp.get("Contents", []), key=lambda x: x["LastModified"]):
    age_h = (now - o["LastModified"]).total_seconds() / 3600
    print(f"{o['LastModified']:%Y-%m-%d %H:%M}  {o['Size']:>12,}  {age_h:6.1f}h  {o['Key']}")
ผลที่ได้ตอนนั้นชัดมากครับ ไฟล์ทุกก้อนของสามสัปดาห์ที่ควรจะมี ไม่มีสักก้อน แล้วชุดล่าสุดชุดเดียวมี LastModified เป็นเวลาสามทุ่มห้าสิบ ซึ่งไม่ใช่เวลาตีสองที่ cron รัน แปลว่าไฟล์ชุดนั้นถูกใครสักคนอัปมือทีหลัง ไม่ใช่ผลงานของระบบอัตโนมัติ ถ้าดูจาก rclone lsl อย่างเดียวจะไม่มีทางเห็นความต่างนี้เลย เพราะมันจะโชว์เวลาตีสองตาม mtime ของไฟล์ต้นทางอย่างสวยงาม
แก้ทั้งเส้น — ให้ปลายทางเป็นตัวตัดสิน
สิ่งที่ผมเปลี่ยนมีสามอย่าง เรียงตามความสำคัญ
- เลิกกลืน stderr ของขาที่คุยกับปลายทาง เก็บข้อความไว้แล้วพิมพ์ตอนล้มพร้อม exit code จะได้รู้ว่าเป็นเรื่องสิทธิ์ เรื่องเน็ต หรือเรื่องเวอร์ชัน
- ให้ backup-all.sh ตรวจย้อนหลังทันทีหลังอัปเสร็จ ว่าไฟล์ที่เพิ่งส่งไปมีอยู่ที่ปลายทางจริงและขนาดตรงกับต้นทาง ไม่ตรงคือล้มเหลว ไม่ใช่คำเตือน
- เพิ่มข้อที่เจ็ดเข้า healthcheck ให้ถามที่ปลายทางว่า object ใหม่สุดอายุเท่าไหร่ เกิน 36 ชั่วโมงเมื่อไหร่ให้แจ้งเตือนแบบเดียวกับตอนเว็บล่ม
ตัวยืนยันหลังอัปเขียนสั้น ๆ ได้แบบนี้ ใช้ rclone size เทียบไบต์ตรง ๆ ไม่ต้องพึ่งเครื่องมืออื่น
verify_remote() {
    local f="$1" name local_size remote_size
    name="$(basename "$f")"
    local_size=$(stat -c %s "$f")
    remote_size=$(rclone size --json "r2:app-backup/$YEAR/$MONTH/$name" 2>/dev/null \
                  | sed -n 's/.*"bytes":\([0-9]*\).*/\1/p')
    if [ "$local_size" != "$remote_size" ]; then
        log "VERIFY FAIL $name local=$local_size remote=${remote_size:-none}"
        return 1
    fi
    log "verified $name ($local_size bytes)"
}
และข้อที่เจ็ดของ healthcheck ซึ่งเป็นบรรทัดที่ควรจะมีตั้งแต่วันแรก
# ข้อ 7 — ของที่ปลายทางต้องใหม่พอ ไม่ใช่แค่ของในเครื่อง
newest_remote=$(rclone lsjson --recursive "r2:app-backup/$(date +%Y)/$(date +%m)/" 2>&1 \
                | sed -n 's/.*"ModTime":"\([^"]*\)".*/\1/p' | sort | tail -n1)
if [ -z "$newest_remote" ]; then
    problem "อ่านรายการที่ปลายทางไม่ได้เลย"
else
    age=$(( ( $(date +%s) - $(date -d "$newest_remote" +%s) ) / 3600 ))
    [ "$age" -gt 36 ] && problem "ไฟล์ใหม่สุดที่ปลายทางอายุ ${age} ชั่วโมง"
fi
ถามคำถามเดียวครับ — ถ้าเครื่องนี้หายไปตอนนี้เลย มีอะไรบอกเราไหมว่าของสำรองชุดล่าสุดคือของเมื่อไหร่ ถ้าคำตอบต้องมาจากการที่คนไปเปิดดูเอง แปลว่าเรายังไม่มีระบบเฝ้าระวัง เรามีแค่นิสัยดีของคนคนหนึ่ง ซึ่งจะหายไปทันทีที่เขาไปยุ่งกับงานอื่น
ของที่ควรตรวจก่อนเชื่อว่า backup ใช้ได้
สุดท้ายผมทำเป็นรายการสั้น ๆ ไว้กับตัวเอง ใครจะเอาไปใช้ก็ตามสะดวก ทั้งหมดตอบคำถามเดียวกันคือ "หลักฐานว่าของมีจริง มาจากฝั่งไหน"
# 1) ปลายทางมีของกี่ก้อน ใหม่สุดวันไหน
rclone lsl r2:app-backup/2569/09/ | sort -k2 | tail -n5

# 2) ไฟล์ที่บีบไว้เปิดออกได้จริงไหม (แค่มีไฟล์ไม่พอ)
gzip -t /opt/appsrv/.private/backups/appsrv_main-*.sql.gz && echo "gzip ok"
tar -tzf /opt/appsrv/.private/backups/code-*.tar.gz > /dev/null && echo "tar ok"

# 3) dump มีเนื้อจริงไม่ใช่ไฟล์เปล่าที่บีบมาสวย ๆ
zcat /opt/appsrv/.private/backups/appsrv_main-*.sql.gz | grep -c '^INSERT INTO'

# 4) ขนาดสองฝั่งตรงกันเป็นไบต์
stat -c '%s %n' /opt/appsrv/.private/backups/*.gz
rclone size r2:app-backup/2569/09/
ข้อสองกับข้อสามสำคัญกว่าที่คิดครับ เพราะ dump ที่ล้มกลางทางก็ยังได้ไฟล์ .sql.gz ออกมาเหมือนกัน แค่ข้างในขาดครึ่ง ขนาดไฟล์ที่ดูใหญ่ดีไม่ได้แปลว่าข้างในครบ ผมเลยชอบให้นับจำนวนบรรทัด INSERT เก็บไว้เทียบกับคืนก่อนหน้าด้วย ถ้าวันไหนหล่นฮวบผิดปกติแปลว่ามีอะไรผิดแล้ว
เรื่องนี้ที่ผมได้กลับมาไม่ใช่เทคนิคอะไรใหม่เลยครับ มันคือการยอมรับว่าทุกขาที่ไม่มีใครยืนยันผลลัพธ์ สักวันจะพังแบบเงียบ ๆ และจะเงียบอยู่อย่างนั้นจนกว่าจะมีคนบังเอิญไปเปิดดู ใครที่ระบบ backup ยังเช็กแต่ของในเครื่องอยู่ ลองเพิ่มบรรทัดถามปลายทางดูสักบรรทัดนะครับ ใช้เวลาไม่ถึงสิบนาที แต่มันคือความต่างระหว่างรู้ตัวในวันเดียวกับรู้ตัวหลังของหายไปแล้วหนึ่งสัปดาห์ ตรงไหนผมเล่าตกหล่นหรือพิมพ์ผิด เดี๋ยวกลับมาแก้เพิ่มให้ภายหลังครับ
อยากให้เราทำให้ไหม?
ให้เราช่วยติดตั้ง ตั้งค่า ย้ายระบบ หรือแก้ปัญหาเซิร์ฟเวอร์ เพื่อให้คุณมีเวลาไปทำงานที่สำคัญกว่า
เคยเจองานแบบนี้ไหม? ติดตรงไหน?
มาแลกวิธีกันต่อในบอร์ด LinuxThai
ความคิดเห็น 0
ยังไม่มีความคิดเห็น — เป็นคนแรกเลย