ทุกชั้นรายงานสำเร็จพร้อมกัน ทั้งที่ผลลัพธ์เป็นขยะ
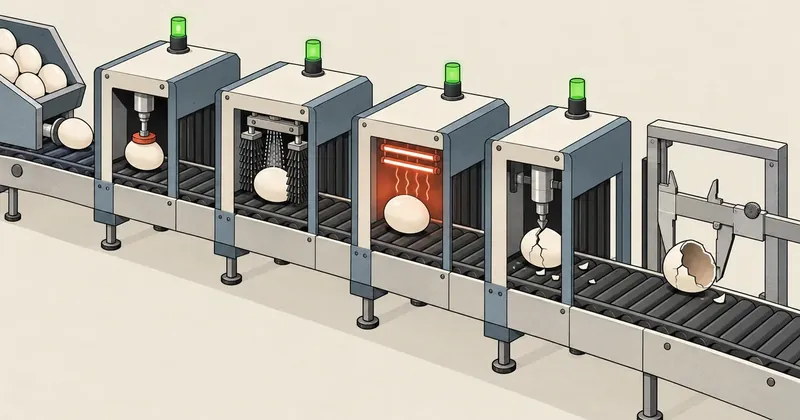
ข้อความว่าสำเร็จมักจะจริงเสมอ ปัญหาคือมันจริงกับขาที่ยังทำงานอยู่ ไม่ใช่ขาที่เราอยากรู้ว่ายังทำงานอยู่หรือเปล่า
สรุปใน 1 นาที
- อาการ/ปัญหา
- งานอัตโนมัติพังพร้อมกันสี่ชั้น แต่ทุกชั้นรายงานว่าสำเร็จ ไม่มี error
- ใครควรอ่าน
- คนดูแลงานอัตโนมัติหรือ pipeline ที่รันโดยไม่มีคนเฝ้า
- ทางแก้แบบสั้น
- เขียน assertion ตรวจผลลัพธ์ปลายทางของขาที่เราอยากรู้ว่ายังทำงาน ไม่เชื่อข้อความว่าสำเร็จจากขาที่ยังทำงานอยู่
พอดีวันหนึ่งมีคนทักมาว่าของบนเว็บไม่อัปเดต ผมเปิด log ของงานอัตโนมัติดูแล้วเจอบรรทัดสำเร็จเรียงกันสวยงามทุกวันไม่ขาดสักวัน พอไล่ลึกลงไปทีละชั้นถึงพบว่าในวันเดียวกันนั้นมีสี่ชั้นที่พังพร้อมกัน และทั้งสี่ชั้นรายงานว่าสำเร็จหมด ไม่มี exception ไม่มี exit code ที่ไม่เป็นศูนย์ ไม่มีบรรทัดสีแดงที่ไหนเลย
ที่น่ากลัวกว่าคือทั้งสี่ชั้นเป็นคนละระบบ เขียนคนละภาษา ทำงานคนละหน้าที่ แต่พังด้วยเหตุผลเชิงโครงสร้างเดียวกัน ผมเลยถือว่านี่ไม่ใช่บั๊กสี่ตัว แต่เป็นความผิดพลาดหนึ่งแบบที่โผล่มาสี่ที่ บทความนี้คือการแกะมันออกมาดูว่ามันคืออะไร แล้วเขียนกฎกันไว้ยังไง
ชื่อเว็บ ชื่อโฮสต์ พาธ และชื่อบริการในบทความเป็นค่าตัวอย่าง ส่วนอาการและวิธีแก้เป็นของจริง
สี่ชั้น หนึ่งวัน ศูนย์ error
ไล่จากปลายน้ำขึ้นต้นน้ำ ทุกชั้นมีข้อความสำเร็จของตัวเองที่พูดความจริงคนละครึ่ง
ชั้นแรก งานส่งไฟล์ขึ้นโฮสต์ รายงานทุกวันว่านำเข้าสำเร็จ 152 รายการ ตัวเลขนี้จริงครับ มันคือจำนวนรายการที่อ่านเข้ามาได้จริง ๆ แต่ขั้นตอนผลักไฟล์ขึ้นเครื่องปลายทางล้มทุกครั้ง เพราะโปรแกรมไปเรียกโปรแกรมส่งไฟล์คนละตัวกับที่ตั้งใจ และค่าที่มันคืนกลับมาถูกทิ้งไปโดยไม่มีใครดู ผลคือเนื้อหาสี่วันอ้างอิงไฟล์ที่ไม่มีอยู่บนเครื่องปลายทาง
ชั้นที่สอง งานเก็บข้อมูลจากเว็บที่ต้องล็อกอิน รายงานทุกวันว่าคุกกี้ใช้ได้ จริงอีกเหมือนกันครับ เพราะมันเช็กว่าคุกกี้มีอยู่ ซึ่งไม่เท่ากับเซสชันยังไม่หมดอายุ ตัวเว็บที่ไม่ได้ล็อกอินก็ยังส่งหน้าออกมาให้ปกติ แค่เป็นหน้าตัวอย่างสาธารณะที่มีแต่ข้อมูลหน้าปกไม่มีเนื้อจริง ระบบเก็บหน้าตัวอย่างนั้นมาเป็นข้อมูลอยู่สิบสามวัน
ชั้นที่สาม งานดึงรายการใหม่จากฟีด รายงานว่านำเข้า 34 รายการทุกวัน แต่รายการที่ได้เป็นชุดเดิมทุกวัน เพราะฟีดนั้นเรียงตามความเกี่ยวข้องไม่ใช่ตามวันที่ พอตัดเอา N ตัวแรกก็ได้ของเดิม แล้วทุกตัวถูกทำเครื่องหมายว่าเคยเห็นแล้ว สรุปคือไม่มีของใหม่เข้าระบบเลยแม้แต่ชิ้นเดียว
ชั้นที่สี่ คิวงานที่ส่งให้ผู้ช่วยประมวลผล รายงานว่างานถูกหยิบไปทำและย้ายเข้าโฟลเดอร์เสร็จแล้ว แต่ไม่มีไฟล์ผลลัพธ์ออกมาสักไฟล์ ไม่มีแม้แต่ไฟล์ที่เขียนค้างครึ่งทาง
บทเรียนที่หนึ่ง — assert ผลลัพธ์ ไม่ใช่ exit code
สิ่งที่ทุกเคสมีเหมือนกันคือเรากำลังวัด "การเรียกใช้" แทนที่จะวัด "ผลที่ได้" คำสั่งรันจบโดยไม่ error ไม่ได้แปลว่าคำสั่งนั้นทำงานที่เราต้องการ
การเรียกสำเร็จ
ฟังก์ชันคืนค่ากลับมาโดยไม่โยน exception · exit code เป็นศูนย์ · ไฟล์ถูกย้ายเข้าโฟลเดอร์เสร็จแล้ว · จำนวนรายการที่อ่านเข้ามาได้ · คุกกี้มีอยู่ในไฟล์ ทั้งหมดนี้เป็นข้อเท็จจริงเรื่องกลไก
ผลลัพธ์มีอยู่และถูกต้อง
ไฟล์ที่ควรจะมีอยู่ที่ปลายทาง มีจริงและขนาดตรง · หน้าที่ดึงมามีเนื้อที่บ่งบอกว่าล็อกอินอยู่ · รายการที่ได้มีอย่างน้อยหนึ่งชิ้นที่ไม่เคยเห็น · ไฟล์ผลลัพธ์มีเนื้อที่ผ่านเกณฑ์ขั้นต่ำ
รูปแบบที่ผมบังคับใช้กับทุกงานอัตโนมัติตอนนี้คือทุกตัวต้องจบด้วยบรรทัดคำตัดสินบรรทัดเดียว และต้องคืน exit code ที่ไม่เป็นศูนย์เมื่อไม่ผ่าน
def finish(problems: list[str]) -> None:
    """ทุกงานจบตรงนี้ที่เดียว — คำตัดสินอยู่ที่บรรทัด RESULT บรรทัดเดียวเท่านั้น"""
    if problems:
        print("RESULT: INCOMPLETE")
        for p in problems:
            print(f"PROBLEM: {p}")
        sys.exit(1)
    print("RESULT: OK")
    sys.exit(0)
ข้อดีของการมีรูปแบบตายตัวคือเฝ้าดูได้ด้วยบรรทัดเดียว ไม่ต้องเขียนตัวอ่าน log แยกให้แต่ละงาน
# ตัวเฝ้าดูของทุกงานเป็นบรรทัดเดียวกันหมด
for f in /var/log/jobs/*.log; do
  tail -n 40 "$f" | grep -q '^RESULT: OK$' || echo "[ERR] $(basename "$f")"
done
บั๊กของชั้นแรกทั้งชั้นคือ ตัวแปรรับค่ากลับตัวเดียวที่ไม่มีใครพิมพ์ออกมาดู โปรแกรมส่งไฟล์ล้มเหลวและคืนค่าบอกอย่างซื่อสัตย์ทุกครั้ง แต่โค้ดเรียกมันแบบทิ้งค่าไปเฉย ๆ แล้วเดินต่อ กฎง่าย ๆ คือขาไหนที่ถ้าพังแล้วผลลัพธ์เสีย ห้ามเรียกแบบทิ้งค่าเด็ดขาด ต้องรับมาตรวจแล้วตัดสินใจทุกครั้ง
บทเรียนที่สอง — มีอยู่ ไม่เท่ากับ ใช้ได้
เคสคุกกี้กับเคสไฟล์ผลลัพธ์เป็นเรื่องเดียวกัน คือเราเอา "การมีอยู่" มาแทน "ความถูกต้อง" เพราะเช็กง่ายกว่ามาก
ไฟล์มีอยู่ ไม่ได้แปลว่าไฟล์ใหม่ ไฟล์ใหม่ไม่ได้แปลว่าข้างในมีเนื้อ ข้างในมีเนื้อไม่ได้แปลว่าเนื้อนั้นคือของที่เราสั่งให้ทำ ทุกก้าวที่ข้ามไปคือช่องให้ความล้มเหลวแอบเข้ามาเงียบ ๆ วิธีตรวจที่ผมใช้คือเขียนเป็นฟังก์ชันเดียวที่ตอบว่า "มีผลงานจริงหรือยัง" แล้วให้มันดูเนื้อในเสมอ
def has_real_output(kind: str, path: Path) -> bool:
    """ดูเนื้อในเสมอ ห้ามตัดสินจากการมีอยู่ของไฟล์"""
    if not path.exists():
        return False
    try:
        data = json.loads(path.read_text(encoding="utf-8"))
    except (json.JSONDecodeError, UnicodeDecodeError):
        return False                     # ไฟล์เสีย = ไม่มีผลงาน ไม่ใช่ error ที่ต้องโยน

    if kind == "translate":
        # ต้องมีรายการที่ได้หัวข้อยาวพอจะเป็นหัวข้อจริง ไม่ใช่ช่องว่างหรือขีด
        return any(len((it.get("title") or "").strip()) >= 8 for it in data)
    if kind == "digest":
        return len(data) > 0 and all(it.get("summary") for it in data)
    return bool(data)
เรื่องเซสชันก็ใช้หลักเดียวกันครับ อย่าถามว่ามีคุกกี้ไหม ให้ถามว่าหน้าที่ได้มามีของที่มีเฉพาะตอนล็อกอินแล้วหรือเปล่า เช่นชื่อผู้ใช้ที่มุมบน หรือปุ่มที่คนไม่ล็อกอินมองไม่เห็น ถ้าไม่เจอของพวกนั้นคือยังไม่ได้ล็อกอิน ไม่ว่าไฟล์คุกกี้จะสมบูรณ์แค่ไหน
MARKERS = ("data-user-id=", 'id="composer"', 'class="account-menu"')

def looks_logged_in(html: str) -> bool:
    # หน้าสาธารณะกับหน้าที่ล็อกอินแล้วมีโครงต่างกัน ตรวจที่โครง ไม่ใช่ที่คุกกี้
    return any(m in html for m in MARKERS)
บทเรียนที่สาม — mtime ไม่ใช่ผลงาน
เคสที่สี่เป็นเคสที่ผมชอบที่สุด เพราะมันสอนเรื่องที่ลึกกว่าเคสอื่น ตัวคิวงานตัดสินว่างานเสร็จหรือยังด้วยบรรทัดเดียว
done = bool(m and m > started) # m = mtime ของไฟล์ผลลัพธ์
อ่านแล้วดูสมเหตุสมผลมากครับ ไฟล์ผลลัพธ์ถูกแตะหลังจากเราสั่งงาน แปลว่างานทำเสร็จแล้ว ปัญหาคือไฟล์ผลลัพธ์นั้นถูกขั้นตอนก่อนหน้าเขียนไว้ไม่กี่วินาทีก่อนสั่งงาน พอตัวคิวมาตรวจรอบแรกซึ่งห่างจากตอนสั่งงานสามนาที มันก็เห็น mtime ใหม่กว่าเวลาที่จดไว้ เลยตีว่าเสร็จทันที ทั้งที่ผู้ประมวลผลยังไม่ได้แตะไฟล์นั้นเลยสักครั้ง
ผลที่ตามมาเป็นลูกโซ่ งานถูกทำเครื่องหมายว่าเสร็จ ขั้นตอนถัดไปหยิบไฟล์ที่ไม่มีเนื้อไปใช้ ได้ผลลัพธ์เปล่า ตัวเผยแพร่เลยไม่มีอะไรจะส่ง และเว็บค้างอยู่อย่างนั้นโดยไม่มี error ที่ไหนเลยทั้งเส้น
ตอนแก้รอบแรกผมเปลี่ยนจากดู mtime มาเป็นดูเนื้อในไฟล์ แล้วเจอปัญหาใหม่ทันที — วันที่ไม่มีอะไรให้ทำ ไฟล์จะไม่ถูกแตะเลย เงื่อนไข "มีผลงาน" เลยไม่มีวันเป็นจริง คิวตันอยู่เจ็ดสิบห้านาทีจนหมดเวลา ปัญหาคือผมพยายามอัดสามสถานการณ์ลงในค่าจริงเท็จสองค่า
ทางแก้คือเลิกใช้ boolean แล้วคืนค่าเป็นสามสถานะ ซึ่งตรงกับความจริงมากกว่า
from enum import Enum

class Produced(str, Enum):
    NOWORK = "nowork"   # ไม่มีอะไรให้ทำตั้งแต่แรก -> จบทันที ไม่ต้องรอ
    DONE   = "done"     # มีผลงานจริง ผ่านเกณฑ์เนื้อหา -> จบแบบสำเร็จ
    WAIT   = "wait"     # ยังไม่มีผลงาน -> รอต่อจนหมดเวลาแล้วรายงานว่าไม่สำเร็จ

MIN_WORK_SEC = 60

def produced(kind: str, path: Path, started: float, pending: int) -> Produced:
    if pending == 0:
        return Produced.NOWORK
    if not has_real_output(kind, path):
        return Produced.WAIT
    m = path.stat().st_mtime
    # ต้องใหม่กว่าเวลาที่สั่งงาน และต้องผ่านเวลาขั้นต่ำด้วย กัน race กับไฟล์ที่เพิ่งเขียนก่อนหน้า
    if m <= started or (time.time() - started) < MIN_WORK_SEC:
        return Produced.WAIT
    return Produced.DONE
ตัว MIN_WORK_SEC เป็นตัวกันชนสำหรับสถานการณ์ที่ไฟล์ถูกเขียนโดยขั้นตอนก่อนหน้าในจังหวะที่ใกล้กับเวลาสั่งงานมาก มันไม่ได้แก้ที่รากของปัญหาหรอกครับ ตัวที่แก้ที่รากคือการดูเนื้อในไฟล์ แต่มันช่วยกันกรณีที่เนื้อในเดิมบังเอิญผ่านเกณฑ์ไปแล้วก่อนที่งานรอบใหม่จะเริ่ม
หลังแก้ ผมให้ทุกบรรทัดใน log ต่อท้ายด้วยเหตุผลที่ตัดสินแบบนั้น เช่น [แปลแล้ว 40/40] หรือ [มีหัวข้อ 307 รายการ] หรือ [ไม่มีรายการที่ต้องทำ] ผลคือเปิด log แล้วรู้ทันทีว่าระบบทำงานจริงหรือแค่ผ่านไป โดยไม่ต้องไปเปิดไฟล์ผลลัพธ์มาดูเอง ตัวเลขในวงเล็บนั่นแหละที่ทำให้เห็นว่าวันไหนผิดปกติ
บทเรียนที่สี่ — อย่าเชื่อลำดับที่เราไม่ได้กำหนดเอง
เคสที่สามสอนเรื่องที่ต่างออกไป คือเราสมมติเอาเองว่าข้อมูลที่ได้มาเรียงตามเวลา ทั้งที่ต้นทางไม่เคยสัญญาแบบนั้น ฟีดนั้นเรียงตามความเกี่ยวข้อง การตัดเอา N ตัวแรกเลยได้ชุดเดิมทุกวัน
สิ่งที่ผมทำคือสองอย่าง หนึ่งคือเรียงใหม่เองด้วยฟิลด์วันที่หลังรับมา สองคือใส่ด่านที่ตรวจว่ารอบนี้ได้ของใหม่จริงไหม ถ้าไม่ได้ให้ถือว่าไม่สำเร็จ
from email.utils import parsedate_to_datetime

# ผิด: เรียงสตริงวันที่แบบ RFC-822 = เรียงตามชื่อวันในสัปดาห์ (Fri, Mon, Sat...)
# items.sort(key=lambda it: it["pubDate"], reverse=True)

# ถูก: แปลงเป็น datetime ก่อนแล้วค่อยเรียง
def pub_dt(it):
    try:
        return parsedate_to_datetime(it["pubDate"])
    except (TypeError, ValueError):
        return datetime.min.replace(tzinfo=timezone.utc)

items.sort(key=pub_dt, reverse=True)

fresh = [it for it in items if it["link"] not in seen]
if not fresh:
    finish(["รอบนี้ไม่ได้รายการใหม่เลยสักชิ้น (ฟีดอาจค้างหรือเรียงผิด)"])
จุดที่ผมโดนเข้าเต็ม ๆ คือบรรทัดที่คอมเมนต์ไว้ข้างบนนั่นแหละครับ วันที่ในฟีดแบบนี้เป็นสตริงที่ขึ้นต้นด้วยชื่อวันในสัปดาห์ พอเรียงแบบสตริงมันเลยเรียงตามตัวอักษรของชื่อวัน ได้ลำดับที่ดูสุ่มแต่คงที่ ซึ่งเนียนมากเพราะมันไม่ได้ error และผลลัพธ์ก็ดูเหมือนเรียงอะไรสักอย่างอยู่
ตอนแรกผมคิดจะแก้ด้วยการยิงขอข้อมูลถี่ขึ้น ซึ่งเป็นความคิดที่ผิดและเปลืองโควตาเปล่า ๆ พอลองปรับจำนวนรายการต่อหน้าจากค่าน้อยเป็นค่ามากขึ้น ที่จำนวนคำขอเท่าเดิม กลับได้ของใหม่เพิ่มขึ้นหลายเท่า เพราะของใหม่มันนั่งอยู่ลึกกว่าที่เราตัดพอดี ก่อนจะเพิ่มความถี่ ให้ดูก่อนว่าเรากำลังมองครบหรือยัง
กฎที่ผมใช้กับทุกงานอัตโนมัติตั้งแต่นั้น
รวบมาเป็นรายการสั้น ๆ ครับ ทั้งหมดนี้ราคาถูกมากถ้าใส่ตั้งแต่วันแรก และแพงมากถ้าไปใส่ทีหลังตอนของหายไปแล้ว
- ทุกงานจบด้วยบรรทัด RESULT บรรทัดเดียว และ exit ด้วยค่าที่ไม่เป็นศูนย์เมื่อไม่ผ่าน คำตัดสินอยู่ที่บรรทัดนั้นที่เดียว ห้ามให้ใครไปตีความจากบรรทัดอื่น
- ขาไหนที่ถ้าพังแล้วผลลัพธ์เสีย ห้ามเรียกแบบทิ้งค่าที่คืนกลับมา
- ตรวจเนื้อในเสมอ อย่าตรวจแค่ว่ามีไฟล์ มีคุกกี้ มีแถว หรือมี process
- ใช้สามสถานะแทนจริงเท็จ เมื่อความจริงมีกรณี "ไม่มีอะไรให้ทำ" ปนอยู่ด้วย
- มีด่านความครบถ้วนต่อชิ้นงาน ของทุกชิ้นที่เนื้อหาอ้างถึง ต้องมีอยู่จริงที่ปลายทาง ไม่ใช่หวังว่ามี
- อย่าเชื่อลำดับที่ต้นทางไม่ได้สัญญา เรียงเองแล้วยืนยันเอง
- ผลว่างหรือ None ส่วนใหญ่เป็นอาการชั่วคราว ไม่ใช่ความจริง ให้ลองซ้ำก่อนที่จะปล่อยให้มันไปลดค่าของจริง
ด่านความครบถ้วนในข้อห้าผมเขียนเป็นฟังก์ชันที่ทั้งซ่อมและรายงานในตัวเดียวกัน เพราะถ้ามันซ่อมได้ก็ควรซ่อม แต่ถ้าซ่อมไม่ได้ต้องพูดออกมาดัง ๆ
def gate(refs: list[str], local_dir: Path, remote_dir: str) -> list[str]:
    """ของทุกชิ้นที่เนื้อหาอ้างถึง ต้องอยู่ปลายทางจริง — ซ่อมได้ก็ซ่อม ซ่อมไม่ได้ก็ต้องดัง"""
    problems = []
    for name in refs:
        if remote_has(remote_dir, name):
            continue
        src = local_dir / name
        if not src.exists():
            problems.append(f"no-local: {name}")
            continue
        rc = push(src, remote_dir)          # รับค่ากลับมาเสมอ ห้ามทิ้ง
        if rc != 0 or not remote_has(remote_dir, name):
            problems.append(f"still-missing: {name} (rc={rc})")
    return problems
วิธีจับความล้มเหลวเงียบที่ได้ผลจริง
ปิดท้ายด้วยเทคนิควินิจฉัยสองอย่างที่ผมใช้ซ้ำแล้วได้ผลทุกครั้ง
อย่างแรกคือเทียบเวลาแก้ไขล่าสุดของชิ้นงานปลายทางกับวันที่เก็บข้อมูล ถ้าโฟลเดอร์ปลายทางมีไฟล์ใหม่สุดเป็นวันที่ตรงกับครั้งสุดท้ายที่เรารันด้วยมือ นั่นแปลว่าระบบอัตโนมัติตายมาตั้งแต่วันนั้น เป็นวิธีที่หาวันตายได้แม่นที่สุดโดยไม่ต้องอ่าน log สักบรรทัด
# ปลายทางหยุดหายใจตั้งแต่เมื่อไหร่
ssh host 'ls -lt --time-style=+%Y-%m-%d /srv/site/assets/ | head -n5'

# นับชิ้นงานต่อวัน ถ้ามีวันที่หายไปเป็นช่วง แปลว่าเส้นนั้นตายช่วงนั้น
ssh host 'ls --time-style=+%Y-%m-%d -l /srv/site/assets/ | awk "{print \$6}" | sort | uniq -c | tail -n20'
อย่างที่สองคือต้องทำซ้ำในสภาพแวดล้อมที่มันพัง เท่านั้น บั๊กของชั้นแรกซ่อนตัวได้นานเพราะเวลาผมเข้าไปทดสอบเองด้วยมือ มันทำงานถูกทุกครั้ง ตัวที่พังคือตอนงานถูกเรียกโดยตัวจัดตารางเวลา ซึ่งมี PATH กับตัวแปรสภาพแวดล้อมคนละชุดกับตอนที่เราเข้าไปพิมพ์เอง
วิธีที่ใช้ได้คือฝากงานหนึ่งชิ้นเข้าไปในคิวเดียวกันนั้นเลย ให้มันรันคำสั่งที่เราอยากรู้แล้วเปลี่ยนทางผลลัพธ์ลงไฟล์ แล้วค่อยไปอ่านไฟล์นั้นทีหลัง
# วางเป็นงานให้ตัวจัดตารางเวลาเรียก อย่ารันเองด้วยมือ
{
  echo "=== whoami/env ตอนถูกเรียกจริง ==="
  whoami
  echo "PATH=$PATH"
  command -v scp ssh python3
  echo "=== ลองขาที่สงสัยจริง ๆ ==="
  scp -v /tmp/probe.txt user@host:/tmp/ 2>&1 | tail -n 20
  echo "rc=$?"
} > /var/log/jobs/probe-from-scheduler.log 2>&1
ผลที่ได้จากไฟล์นั้นตอบทุกอย่างในสามบรรทัด และเป็นคำตอบที่ผมหาไม่เจอเลยตอนนั่งไล่ด้วยมืออยู่สองวัน
สรุปสำหรับตัวเองคือ ทุกขาในระบบอัตโนมัติที่ไม่มีใครยืนยันผลลัพธ์ สักวันจะพัง และวันที่มันพังจะไม่มีใครรู้ ข้อความว่าสำเร็จที่เราเห็นทุกวันนั้นมันจริงเสมอ แค่มันจริงกับขาที่ยังทำงานอยู่ ไม่ใช่ขาที่เราอยากรู้ ใครมีระบบอัตโนมัติที่รันมานานโดยไม่เคยมีใครไปตรวจผลลัพธ์ปลายทาง ลองเปิดดูสักรอบนะครับ ตรงไหนผมอธิบายตกหล่นหรือพิมพ์ผิด เดี๋ยวกลับมาแก้เพิ่มให้ภายหลังครับ
เคยเจองานแบบนี้ไหม? ติดตรงไหน?
มาแลกวิธีกันต่อในบอร์ด LinuxThai
ความคิดเห็น 0
ยังไม่มีความคิดเห็น — เป็นคนแรกเลย