ชื่อคนไทยถูกตัดขึ้นบรรทัดใหม่กลางคำ เพราะเบราว์เซอร์ตัดคำด้วยพจนานุกรม
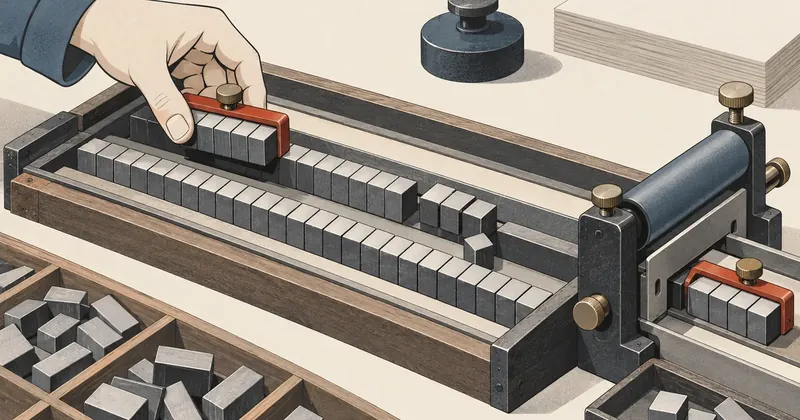
ภาษาไทยไม่มีช่องว่างคั่นคำ เบราว์เซอร์เลยต้องเดาเองว่าตัดบรรทัดได้ตรงไหน และมันเดาจากพจนานุกรม ชื่อคนที่ไม่อยู่ในพจนานุกรมคือคำที่มันเดาผิดได้ทุกครั้งที่ชื่อนั้นไปตกท้ายบรรทัด
สรุปใน 1 นาที
- อาการ/ปัญหา
- ชื่อเล่นที่ไม่อยู่ในพจนานุกรมของเบราว์เซอร์ถูกหักกลางคำที่ท้ายบรรทัด
- ใครควรอ่าน
- คนทำเว็บภาษาไทยที่เนื้อหามาจากฐานข้อมูล
- ทางแก้แบบสั้น
- ทำ middleware ครอบ response ห่อชื่อจากตารางทีมงานด้วย span nowrap เฉพาะ text node แทนการแก้ CSS รายจุด
พอดีเจ้าของเว็บรายหนึ่งส่งภาพหน้าจอมาให้ผมดู เป็นชื่อเล่นของเขาเองในฟุตเตอร์ ชื่อพยางค์เดียว สะกดไม่ตรงกับคำไหนในพจนานุกรม ตัวอักษรตัวสุดท้ายของชื่อตกลงไปอยู่บรรทัดใหม่ตัวเดียว ส่วนที่เหลือค้างอยู่ท้ายบรรทัดบน ผมไล่ดูต่อก็เจอแบบเดียวกันในการ์ดทีมงานและในเนื้อบทความ คำสั่งที่ได้มาสั้นมาก คือ อย่าให้เป็นแบบนี้ ทุกคน ทุกบทความ
ชื่อคนในบทความนี้เป็นชื่อสมมติทั้งหมด ผมจะใช้ชื่อเล่นว่า ปริ่ม กับชื่อเต็มว่า ปริ่ม วรรณศิริ แทนของจริง ส่วนโครงโค้ด ตัวเลข และผลข้างเคียงคือของที่เกิดขึ้นจริง
อาการ: ชื่อถูกหักกลางคำ และเกิดได้ทุกที่ที่ชื่อไปตกท้ายบรรทัด
ข้อความอย่าง "ติดต่อทีมงานได้ที่คุณปริ่ม ตลอดงาน" ในกล่องแคบ ๆ ถ้าความกว้างพอดีจนตัว ม ล้นขอบ เบราว์เซอร์จะตัดบรรทัดหลัง ปริ่ แล้วเอา ม ลงไปขึ้นบรรทัดใหม่ สำหรับคนอ่านไทยมันคือคำที่ขาดครึ่ง สำหรับเจ้าของชื่อมันคือชื่อตัวเองที่เขียนผิดบนเว็บตัวเอง
ความคิดแรกของผมคือมันเป็นปัญหา CSS ของ component นั้น ใส่ white-space: nowrap ให้ชื่อตรงจุดที่เห็นก็จบ ซึ่งแก้ได้เฉพาะจุดที่ใส่ อีกสองที่ในภาพหน้าจอยังเป็นอยู่ และพอคิดต่อก็เห็นว่าไล่แก้แบบนี้ไม่มีวันจบ เพราะชื่อทีมงานไม่ได้อยู่แค่ในเทมเพลต มันอยู่ในเนื้อหาที่มาจากฐานข้อมูลด้วย บทความราว 800 เรื่อง รีวิวลูกค้า หน้ารายการบริการ ทุกที่ที่มีคนพิมพ์ชื่อทีมงานลงไปในข้อความ ผมไม่มีทางรู้ล่วงหน้าว่าชื่อไหนจะไปตกท้ายบรรทัดที่ความกว้างจอเท่าไร
สาเหตุ: เบราว์เซอร์หาจุดตัดบรรทัดภาษาไทยจากพจนานุกรม
ภาษาที่เว้นวรรคระหว่างคำ เบราว์เซอร์ตัดบรรทัดตรงช่องว่างได้เลย ภาษาไทยเขียนติดกันทั้งประโยค เบราว์เซอร์เลยมีพจนานุกรมคำไทยอยู่ในตัว แล้วใช้มันแบ่งข้อความเป็นคำเพื่อหาว่าตรงไหนตัดบรรทัดได้ คำที่อยู่ในพจนานุกรมจะไม่ถูกหักกลาง
ปัญหาอยู่ที่ชื่อเฉพาะ ชื่อเล่นคนไทยจำนวนมากเป็นคำที่สะกดเฉพาะตัว ไม่ตรงกับคำในพจนานุกรม ตัวแบ่งคำเลยพยายามแยกมันเป็นชิ้นที่มันรู้จัก หรือเหลือเศษตัวอักษรไว้เป็นคำของตัวเอง ผลคือกลางชื่อมีจุดที่เบราว์เซอร์ถือว่าตัดบรรทัดได้ ปกติมองไม่เห็นอะไรเลย จนกว่าชื่อนั้นจะไปอยู่ท้ายบรรทัดพอดี
เรื่องนี้ต่างจากปัญหาข้อมูลไทยตอนนำเข้า ซึ่งผมเขียนไว้ที่ นำเข้าข้อมูลไทยให้ไม่พัง ตรงนั้นข้อมูลในฐานผิด ตรงนี้ข้อมูลถูกทุกตัวอักษร ที่ผิดคือการจัดบรรทัดตอนแสดงผล และมันเกิดที่เครื่องของคนดู ไม่ใช่ที่เซิร์ฟเวอร์
ทางเลือกที่ไม่ได้ใช้
ก่อนลงมือผมไล่ทางเลือกอยู่สามทาง
สามทางที่ตัดออก
- ใส่ nowrap ใน blade รายจุด: ไม่ครอบเนื้อหาจากฐานข้อมูล
- แทรกอักขระ word joiner ในชื่อ: ข้อมูลในฐานเปลี่ยน ค้นหากับคัดลอกชื่อแล้วได้อักขระแฝง
- word-break: keep-all: กระทบการตัดบรรทัดทั้งย่อหน้า
middleware ครอบ response
- ทำที่เดียว ครอบทุกหน้าสาธารณะ
- ข้อมูลในฐานไม่ถูกแตะ
- รายชื่อมาจากตาราง เพิ่มคนไม่ต้องแก้โค้ด
- ต้นทุน: regex หนึ่งรอบต่อหน้า
ทางที่เลือกคือทำที่ชั้นท้ายสุดของ response HTML ทุกหน้าที่กำลังจะส่งออกไป ผ่าน middleware ตัวเดียว หาชื่อที่รู้จักในข้อความ แล้วห่อด้วย <span class="nw"> โดยมี CSS บรรทัดเดียวรองรับ
.nw { white-space: nowrap; }
middleware: แตะเฉพาะ text node
ความเสี่ยงของการแก้ HTML ด้วย regex คือไปแก้ผิดที่ ถ้าชื่อไปอยู่ใน alt ของรูป ใน <title> ใน meta description หรือใน JSON-LD แล้วผมยัดแท็ก span เข้าไป หน้าจะพังหรือข้อมูลที่ Google อ่านจะมีแท็กปน ผมเลยไม่ regex ทั้งก้อน แต่แตก HTML เป็นชิ้นก่อน
<?php

namespace App\Http\Middleware;

use Closure;
use Illuminate\Http\Request;
use Symfony\Component\HttpFoundation\Response;

class KeepNamesTogether
{
    public function handle(Request $request, Closure $next): Response
    {
        $response = $next($request);

        // เฉพาะหน้า HTML สาธารณะ: ข้ามหลังบ้าน api และหน้า login
        if (! $request->isMethod('GET') || $request->is('admin*', 'api/*', 'login')
            || ! str_contains((string) $response->headers->get('Content-Type'), 'text/html')) {
            return $response;
        }
        $html = $response->getContent();
        if (! is_string($html) || $html === '' || ! ($pattern = $this->pattern())) {
            return $response;
        }
        $response->setContent($this->wrap($html, $pattern));

        return $response;
    }

    private function wrap(string $html, string $pattern): string
    {
        // ตัวคั่น = บล็อกที่ห้ามแตะทั้งก้อน หรือแท็กหนึ่งตัว
        $parts = preg_split(
            '/(<(?:script|style|title|textarea|option)\b.*?<\/(?:script|style|title|textarea|option)>|<[^>]*>)/isu',
            $html, -1, PREG_SPLIT_DELIM_CAPTURE
        );
        if ($parts === false) {
            return $html;                       // regex ล้ม: ส่งของเดิมออกไป ไม่ทำหน้าพัง
        }
        foreach ($parts as $i => $p) {
            // ชิ้นเลขคู่ = text node และทำเฉพาะชิ้นที่มีอักษรไทย
            if ($i % 2 === 0 && $p !== '' && preg_match('/[\x{0E00}-\x{0E7F}]/u', $p)) {
                $parts[$i] = preg_replace($pattern, '<span class="nw">$0</span>', $p) ?? $p;
            }
        }

        return implode('', $parts);
    }
}
หลักที่ผมยึดคือถ้าอะไรผิดพลาด ให้ส่ง HTML เดิมออกไป preg_split คืน false ก็คืนของเดิม preg_replace คืน null ก็ใช้ชิ้นเดิม pattern ว่างก็ข้าม middleware ตัวนี้เป็นของแต่งหน้า มันไม่ควรมีสิทธิ์ทำให้หน้าเว็บล่ม
การตรวจว่าชิ้นนั้นมีอักษรช่วง U+0E00 ถึง U+0E7F ก่อนเป็นทางลัด ชิ้นที่เป็นช่องว่าง ตัวเลข หรืออังกฤษล้วนจะไม่เสียเวลาเข้า regex ชื่อเลย
ข้อมูลโครงสร้างสำหรับเครื่องมือค้นหาอยู่ใน <script type="application/ld+json"> ถ้า span หลุดเข้าไปในนั้น JSON ยัง parse ได้แต่ชื่อผู้เขียนจะมีแท็ก HTML ปนไปด้วย ส่วน textarea ถ้าถูกห่อ คนกรอกฟอร์มจะเห็นแท็กเป็นตัวหนังสือในช่องกรอก pattern ที่ใช้ split จับสองบล็อกนี้ทั้งก้อนตั้งแต่แท็กเปิดถึงแท็กปิด มันเลยตกไปอยู่ชิ้นเลขคี่และไม่ถูกแตะ
รายชื่อมาจากตาราง ไม่ได้เขียนไว้ในโค้ด
pattern ของชื่อสร้างจากฐานข้อมูล ชื่อเล่นและชื่อเต็มของทีมงานทุกคน บวกกับชื่อผู้รีวิว แล้วเก็บ cache ไว้หนึ่งชั่วโมง
use App\Models\Review;
use App\Models\TeamMember;
use Illuminate\Support\Facades\Cache;

/** คำที่โผล่ในคอลัมน์ชื่อ แต่ไม่ใช่ชื่อ */
private const STOP = ['คุณ', 'ครอบครัว', 'ท่าน', 'และ', 'แพ็กเกจ', 'งาน', 'รีวิว', 'คณะ',
    'กับ', 'ของ', 'จาก', 'สาขา', 'พี่', 'น้อง', 'บริษัท', 'จำกัด', 'ลูกค้า',
    'หัวหน้าทีม', 'ผู้ประสานงาน', 'ใหม่'];

private function pattern(): ?string
{
    return Cache::remember('nw_pattern_v2', 3600, function () {
        $tokens = [];
        $add = function (?string $text) use (&$tokens) {
            foreach (preg_split('/[\s"\'()\/,]+/u', (string) $text) ?: [] as $t) {
                $t = trim($t, " \t-.");
                if (mb_strlen($t) >= 3 && mb_strlen($t) <= 24
                    && preg_match('/^[\x{0E00}-\x{0E7F}.]+$/u', $t)
                    && ! in_array($t, self::STOP, true)) {
                    $tokens[$t] = true;
                }
            }
        };
        foreach (TeamMember::query()->get(['nickname', 'full_name_th']) as $m) {
            $add($m->nickname);
            $add($m->full_name_th);
        }
        foreach (Review::query()->pluck('name') as $n) {
            // ชื่อผู้รีวิว: รับเฉพาะที่ยาวไม่เกิน 3 คำ กันช่องชื่อที่คนกรอกเป็นประโยค
            if (count(preg_split('/\s+/u', trim((string) $n)) ?: []) <= 3) {
                $add($n);
            }
        }
        if (! $tokens) {
            return '';
        }
        $list = array_keys($tokens);
        usort($list, fn ($a, $b) => mb_strlen($b) <=> mb_strlen($a));   // ยาวไปสั้น

        return '/(?:'.implode('|', array_map(fn ($t) => preg_quote($t, '/'), $list)).')/u';
    }) ?: null;
}
มีการตัดสินใจอยู่หลายจุดในฟังก์ชันนี้ และแต่ละจุดมาจากเหตุผลจริง
- ชื่อเต็มถูกแตกเป็น token ตามช่องว่างและเครื่องหมาย "ปริ่ม วรรณศิริ" ได้สอง token คือ ปริ่ม กับ วรรณศิริ ชื่อกับนามสกุลเลยยังขึ้นบรรทัดใหม่ตรงช่องว่างได้ ห้ามแค่หักกลาง token ถ้าห่อทั้งชื่อเต็มเป็นก้อนเดียว กล่องแคบ ๆ จะล้นแทน
- รับเฉพาะ token ไทยล้วน ยาว 3 ถึง 24 ตัวอักษร สั้นกว่านั้นมีโอกาสไปตรงกับส่วนหนึ่งของคำทั่วไปสูงเกิน ยาวกว่านั้นไม่ใช่ชื่อแล้ว
- ชื่อผู้รีวิวรับเฉพาะที่ยาวไม่เกิน 3 คำ เพราะช่องชื่อของรีวิวบางรายการถูกกรอกเป็นประโยค เช่น ครอบครัวไหนซื้ออะไร ถ้ารับมาทั้งหมด คำธรรมดาจะกลายเป็นชื่อ
- เรียงยาวไปสั้นก่อนต่อเป็น alternation regex เลือกตัวแรกที่ตรง ถ้ามีคนชื่อ ปริ่ม กับอีกคนชื่อ ปริ่มฟ้า แล้ว ปริ่ม อยู่หน้า มันจะห่อแค่ ปริ่ม แล้วปล่อย ฟ้า ไว้ข้างนอก ชื่อยาวก็ยังถูกหักได้เหมือนเดิม
preg_quoteทุกตัว เพราะชื่อมาจากช่องที่คนกรอก จุดหรือเครื่องหมายที่หลงมาต้องไม่กลายเป็นคำสั่ง regex- คีย์ cache มีเลขรุ่นต่อท้าย เวลาเปลี่ยนกฎ เช่น เพิ่มคำใน stop list ผมขยับเลขรุ่นแล้ว pattern เก่าก็ถูกทิ้งเองโดยไม่ต้องสั่งล้าง cache ทั้งระบบ
ผลที่ได้ในทางปฏิบัติคือ เพิ่มทีมงานคนใหม่ในหลังบ้าน ชื่อใหม่มีผลกับทุกหน้าภายในหนึ่งชั่วโมงโดยไม่ต้องแก้โค้ดหรือ deploy
ลงทะเบียน middleware ไว้ท้ายกลุ่ม web
// bootstrap/app.php
->withMiddleware(function (Illuminate\Foundation\Configuration\Middleware $middleware) {
    $middleware->web(append: [
        \App\Http\Middleware\KeepNamesTogether::class,
    ]);
})
ผลข้างเคียงที่ 1: ชื่อในหัวกล่องแชทตัวเล็กลง
หลังขึ้นจริงผมไล่ตรวจหน้าจอ desktop 17 หน้า ที่ความกว้าง 1280 1440 และ 1920 รวม 51 รอบ แล้วเจอของที่ไม่ได้คาดไว้ หัวกล่องแชทมีข้อความที่มีชื่อทีมงานอยู่ด้วย ชื่อนั้นตัวเล็กกว่าคำข้างเคียงอย่างเห็นได้ชัด
ต้นเหตุคือ CSS ของหัวกล่องแชทเขียนเล็งลูกแบบกว้างไว้
/* รูปแบบของปัญหา (ชื่อ class กับตัวเลขเป็นตัวอย่าง): ตั้งใจเล็งป้ายสถานะที่เป็น span ในหัวกล่อง */
.chat-head span { font-size: 12px; opacity: .8; }

/* แก้: เล็งด้วย class ของสิ่งที่ตั้งใจจริง */
.chat-head .status { font-size: 12px; opacity: .8; }
ตอนเขียน CSS บรรทัดนั้น ในหัวกล่องมี span อยู่ตัวเดียวคือป้ายสถานะ selector แบบ .chat-head span เลยทำงานถูก พอ middleware ฉีด span ตัวใหม่เข้าไปครอบชื่อ มันก็โดนกฎเดียวกันไปด้วย แก้แล้วผมวัดขนาดตัวอักษรได้ 15px เท่ากันทั้งบรรทัด
บทเรียนคือ การฉีด element เข้าไปใน HTML ที่คนอื่นเขียน CSS ไว้แล้ว จะไปชนกับ selector ที่เล็งด้วยชื่อแท็ก ตัวตรวจที่ผมใช้หาเคสแบบนี้คือสคริปต์สั้น ๆ ในคอนโซลของเบราว์เซอร์
// หา span.nw ที่หน้าตาไม่เหมือนข้อความรอบตัว
document.querySelectorAll('span.nw').forEach((el) => {
  const a = getComputedStyle(el);
  const b = getComputedStyle(el.parentElement);
  for (const k of ['fontSize', 'fontWeight', 'color', 'opacity']) {
    if (a[k] !== b[k]) {
      console.log('[DIFF]', k, a[k], '!=', b[k], el.textContent, el.parentElement);
    }
  }
});
ผลข้างเคียงที่ 2: ชื่อเล่นที่เป็นคำสามัญไปล็อกหัวข้อบริการ
ข้อที่สองแปลกกว่า ทีมงานคนหนึ่งมีชื่อเล่นเป็นคำสามัญ สมมติว่าชื่อ ใหม่ พอชื่อนี้เข้าไปอยู่ใน pattern ทุกที่ในเว็บที่มีคำว่า ใหม่ ก็ถูกห่อด้วย span nowrap ทั้งหมด รวมถึงหัวข้อบริการที่มีคำนี้อยู่ในชื่อ การ์ดบริการใช้ line-clamp ตัดหัวข้อที่ยาวเกิน พอมีก้อน nowrap อยู่กลางหัวข้อ ตำแหน่งที่จุดไข่ปลาโผล่ก็เพี้ยนไปจากการ์ดใบอื่น
ทางแก้คือ stop list ที่เห็นในโค้ดข้างบน คำนำหน้า คำทั่วไป และตำแหน่งงานที่โผล่ในคอลัมน์ชื่อ ถูกตัดออกจาก pattern รวมถึงชื่อเล่นที่เป็นคำสามัญด้วย
ปัญหาตั้งต้นเกิดกับชื่อที่ไม่มีในพจนานุกรมของเบราว์เซอร์ ชื่อเล่นที่เป็นคำสามัญอยู่ในพจนานุกรมอยู่แล้ว เบราว์เซอร์ไม่หักมันตั้งแต่ต้น การห่อมันเลยไม่ได้ช่วยอะไร มีแต่ผลข้างเคียง กฎที่ใช้ตัดสินว่าคำไหนควรเข้า stop list คือถามว่า คำนี้เป็นคำในภาษาที่คนใช้ทั่วไปหรือเปล่า ถ้าใช่ก็ไม่ต้องห่อ
ข้อนี้ผมประเมินผิดตั้งแต่ตอนออกแบบ ผมคิดว่าการห่อคำเกินจำเป็นไม่มีต้นทุน ห่อไว้ก่อนปลอดภัยกว่า แต่ nowrap เปลี่ยนพฤติกรรมการจัดบรรทัดของทุกอย่างที่มันครอบ มันมีต้นทุนเสมอ แค่มองไม่เห็นจนกว่าจะไปเจอ layout ที่พึ่งการตัดบรรทัดตามธรรมชาติ
ต้นทุนและขอบเขต
ต้นทุนต่อคำขอคือ preg_split หนึ่งครั้งกับ regex ชื่อบนชิ้นข้อความที่มีอักษรไทย query ที่ดึงรายชื่อถูก cache ไว้ เลยเกิดชั่วโมงละครั้ง ขอบเขตที่ต้องรู้คือ middleware ทำงานเฉพาะ response ที่ผ่าน PHP ถ้าวันหนึ่งมี cache ทั้งหน้าที่ชั้นหน้าเซิร์ฟเวอร์ หน้าที่ถูกเก็บก็คือหน้าที่ห่อแล้ว ซึ่งใช้ได้ แต่ชื่อใหม่จะมีผลช้ากว่าหนึ่งชั่วโมงตามอายุ cache ของชั้นนั้น และเนื้อหาที่ JavaScript เติมเข้ามาทีหลังจะไม่ถูกห่อ เพราะมันไม่ได้อยู่ใน HTML ตอนออกจากเซิร์ฟเวอร์
สรุปคือชื่อเฉพาะภาษาไทยถูกหักกลางคำได้เพราะเบราว์เซอร์ไม่รู้จักมัน และทางแก้ที่ครอบทุกหน้าคือบอกเบราว์เซอร์ทีละชื่อว่าห้ามตัด โดยทำที่ชั้นเดียวหลังสุด แตะเฉพาะข้อความ ใช้รายชื่อจากตาราง และไม่ห่อคำที่เบราว์เซอร์รู้จักอยู่แล้ว ส่วนตัวผมถ้าเว็บมีชื่อเฉพาะแค่ไม่กี่จุดในเทมเพลต ใส่ class รายจุดก็พอ ไม่ต้องถึง middleware ทางนี้คุ้มเมื่อชื่อกระจายอยู่ในเนื้อหาที่คนพิมพ์ ใครจะเอาไปใช้ก็ปรับ stop list ให้เข้ากับคำในเว็บตัวเอง ตรงไหนผมอธิบายตกหล่น เดี๋ยวกลับมาแก้เพิ่มให้ภายหลังครับ
อยากให้เราทำให้ไหม?
ให้เราช่วยติดตั้ง ตั้งค่า ย้ายระบบ หรือแก้ปัญหาเซิร์ฟเวอร์ เพื่อให้คุณมีเวลาไปทำงานที่สำคัญกว่า
เคยเจองานแบบนี้ไหม? ติดตรงไหน?
มาแลกวิธีกันต่อในบอร์ด LinuxThai
ความคิดเห็น 0
ยังไม่มีความคิดเห็น — เป็นคนแรกเลย