แชทบอทบันทึก LINE ID เป็นคำว่า add: ให้เซิร์ฟเวอร์ตรวจก่อนเขียน CRM
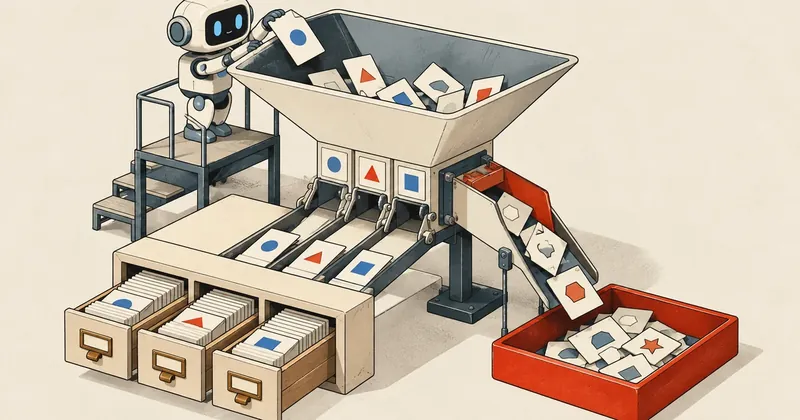
ข้อมูลที่แชทบอทเก็บมาจากบทสนทนาจริงดูน่าเชื่อถือเสมอ จนกระทั่งมีคนเปิดระเบียนลูกค้าแล้วเห็นว่าไอดีไลน์ของเขาคือคำว่า add
สรุปใน 1 นาที
- อาการ/ปัญหา
- แชทบอทบันทึกคำว่า add เป็น LINE ID ในระเบียนลูกค้า เพราะ regex หลวมและเซิร์ฟเวอร์เชื่อทุกค่า
- ใครควรอ่าน
- คนทำแชทบอทที่เขียนข้อมูลลง CRM หรือระเบียนลูกค้าเอง
- ทางแก้แบบสั้น
- ให้เซิร์ฟเวอร์ตรวจทุกช่องก่อนเขียน มี stop list กฎไม่เขียนทับ และสคริปต์แก้ข้อมูลเก่าที่รันซ้ำได้ โดย dump ก่อนเสมอ
พอดีผมไล่ตรวจระเบียนลูกค้าที่แชทบอทของเว็บลูกค้ารายหนึ่งเขียนลงฐานข้อมูลเอง เพราะสงสัยว่าบอทเก็บค่าผิดเข้ามา พอเปิดดูช่องไอดีไลน์ของระเบียนหนึ่ง ค่าในช่องคือคำว่า add ทั้งที่ในบทสนทนาลูกค้าแค่พิมพ์ว่า "line add ไปแล้ว" หมายถึงเขากดเพิ่มเพื่อนไปแล้ว ไม่ได้บอกไอดี
ผมตามไล่ต่อหลายชั้นก็พบว่าเรื่องนี้ไม่ได้มาจากบั๊กเดียว มันคือการที่ระบบปล่อยให้ regex กับโมเดลเขียนฐานข้อมูลโดยตรง และฝั่งเซิร์ฟเวอร์เชื่อทุกอย่างที่ฝั่งบอทส่งมา บทความนี้เล่าว่าผมแก้อย่างไร ชื่อลูกค้า รหัสเคส และข้อมูลส่วนตัวในบทสนทนาจริงผมตัดออกหมด ที่เหลือใช้ตัวอย่างสมมติ
ขนาดของความเสียหาย: น้อย แต่แสบ
ผมตรวจย้อนหลังทั้งชุดแล้วเขียนเป็นรายงานตรวจสอบ ผลคือลูกค้าที่ถูกบันทึกผิดจริงมี รายเดียว ผมอยากเล่าให้ตรงขนาด เพราะบทความแนวนี้ชอบทำให้ปัญหาดูใหญ่เกินจริง ข้อมูลที่เสียน้อยมาก แต่ความรำคาญสูง เพราะระเบียนลูกค้าคือสิ่งที่พนักงานเปิดดูก่อนโทรกลับ ถ้าช่องติดต่อผิดแม้รายการเดียว ความเชื่อใจในทั้งระบบก็ลดลงทันที
รูปแบบความผิดที่เจอ
จากรายงานตรวจสอบ ความผิดเกิดซ้ำเป็นแบบเดียวกันเกือบทั้งหมด
- regex หลวมเอาคำที่อยู่หลังคำว่า line เป็นไอดี เช่น "line add ไปแล้ว" กลายเป็น LINE ID ว่า
add - เอาคำที่อยู่หลังคำว่า "ชื่อ" เป็นชื่อลูกค้า เช่น ลูกค้าพิมพ์ "ชื่อไลน์ Xxxx" บอทเอาคำว่า "ไลน์" ไปเป็นชื่อ
- โมเดลใส่ประโยคทั้งประโยคลงในช่องไอดี
- เซิร์ฟเวอร์ถือว่าทุกอย่างที่ไม่ใช่อีเมลหรือเบอร์โทรเป็น LINE ID และเขียนทับข้อมูลติดต่อเดิม รวม 3 ครั้ง
- รายละเอียดคำขอของลูกค้าหายไป เพราะตอนข้อมูลมา ระเบียนลูกค้ายังไม่ถูกสร้าง ไม่มีที่ให้เก็บ
ข้อสี่คือต้นเหตุจริงครับ ข้อหนึ่งถึงสามเป็นแค่เชื้อเพลิง ต่อให้ฝั่งบอทส่งค่าผิดมา เซิร์ฟเวอร์ที่ตรวจเป็นก็ปฏิเสธได้ แต่เซิร์ฟเวอร์ที่เชื่อทุกอย่างทำให้ค่าผิดทุกค่าลงฐานข้อมูลได้เสมอ
หลักข้อเดียว: เซิร์ฟเวอร์ไม่เชื่อไคลเอนต์
ส่วนตัวผมถือหลักข้อเดียวเป็นหลักของงานนี้ ไม่ว่าไคลเอนต์ที่ส่งค่ามาจะเป็นเบราว์เซอร์ แอปมือถือ หรือแชทบอทที่ใช้โมเดลภาษา เซิร์ฟเวอร์ต้องตรวจค่านั้นเองก่อนเขียนเสมอ เหตุผลที่ผมเขียนเป็นเรื่องแยกให้ AI ฝั่งอ่านเอกสาร ก็ใช้หลักเดียวกัน (อ่านต่อที่ ai-extract-code-validates) บทความนั้นเล่าเรื่องให้โค้ดตรวจผลที่โมเดลสกัดมา ส่วนบทความนี้คือกรณีที่โมเดลเขียนฐานข้อมูลตรง ๆ ซึ่งความเสี่ยงสูงกว่ามาก เพราะผิดแล้วคือผิดในระเบียนจริง
ข้อความที่โมเดลหรือ regex แยกออกมาเป็นแค่ข้อเสนอว่าค่านี้น่าจะเป็นชื่อหรือเบอร์ มันไม่ใช่ข้อเท็จจริง ต้องผ่านตัวตรวจฝั่งเซิร์ฟเวอร์ที่เป็นโค้ดธรรมดาก่อนทุกครั้ง และถ้าตรวจไม่ผ่านต้องรายงานแต่ไม่เก็บ ไม่ใช่เก็บไว้ก่อนแล้วค่อยแก้
ตัวตรวจต่อช่อง: ContactNormalizer
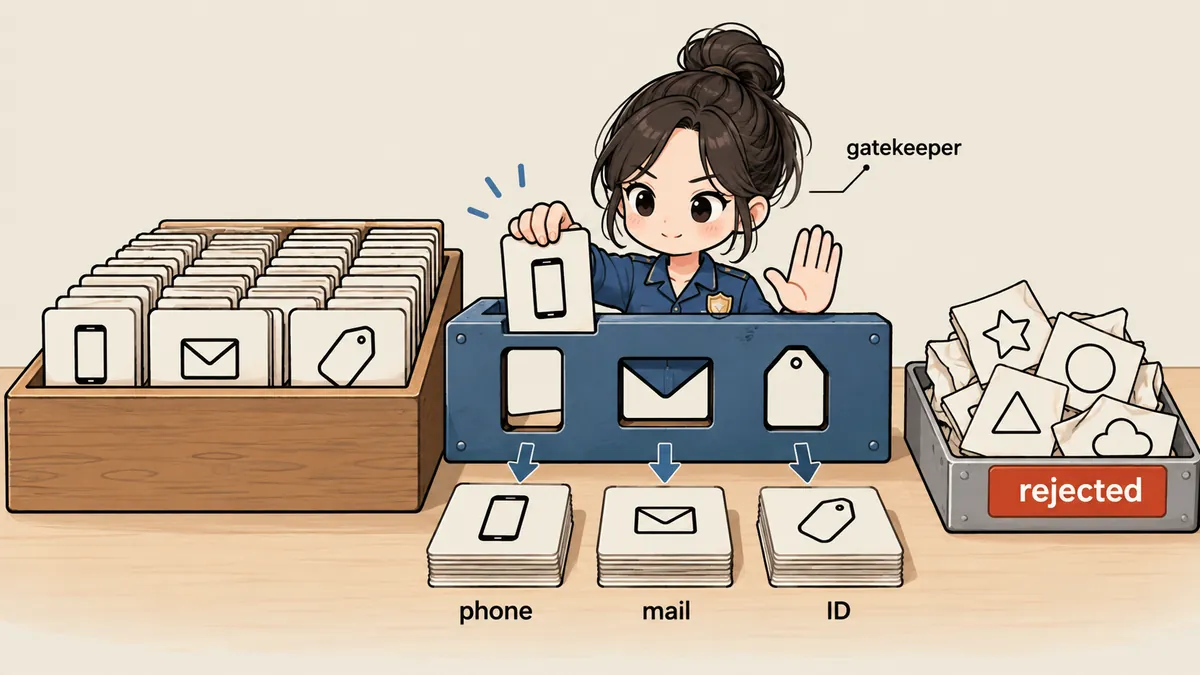
ผมเขียนตัวตรวจแยกต่อช่อง คือชื่อ เบอร์ อีเมล และไอดีไลน์ แต่ละช่องมีกติกาของตัวเอง และมี stop list ซึ่งเป็นรายการคำที่ห้ามถือเป็นค่าในช่องนั้นเด็ดขาด
ช่องชื่อ ตัวตรวจทำสี่อย่าง ตัดคำนำหน้า "ชื่อ" กับ "ชื่อเล่น" ออก ตัดคำลงท้ายอย่าง ค่ะ คะ ครับ จ้า นะ ปฏิเสธเมื่อว่างหรือยาวเกิน 80 ตัวอักษรหรือมีตัวเลข เครื่องหมาย @ ลิงก์ หรือเครื่องหมาย : และ / และปฏิเสธเมื่อคำแรกเป็นคำที่บอกชื่อช่องทาง (ไลน์ เบอร์ โทร อีเมล) หรือทั้งก้อนอยู่ในรายการคำที่ไม่ใช่ชื่อ (คำทักทาย คำลงท้ายเดี่ยว ๆ และคำอย่าง admin unknown null none) ตัวอย่างที่เคยผิดคือ "ชื่อไลน์ Xxxx" ซึ่งเคยกลายเป็นชื่อว่า "ไลน์" ตอนนี้ถูกปฏิเสธเพราะคำแรกเป็นคำช่องทาง
ช่องไอดีไลน์เข้มกว่านั้น ต้องไม่อยู่ใน stop list และต้อง "ดูเป็นไอดี" ไม่ใช่ประโยค stop list ของช่องนี้มีคำอย่าง add, added, id, line, lineid, me, my, ok, sticker, official, already, done, chat, name, no, none, yes และไอดีบัญชีทางการของเราเอง เหตุผลที่ต้องใส่ไอดีของเราเองคือลูกค้ามักพิมพ์ชื่อบัญชีของเรากลับมาในข้อความ ("add ไลน์ xxx แล้วนะ") ถ้าไม่ดักไว้ ไอดีของเราจะไปอยู่ในระเบียนของลูกค้า
โค้ดด้านล่างเป็นตัวอย่างสมมติเพื่อให้เห็นแนวคิด (รูปแบบจริงของไอดีไลน์ผมไม่ลงรายละเอียด) ไม่ใช่ตัวเต็มที่รันอยู่
<?php
final class ContactNormalizer
{
    private const LINE_STOP = [
        'add', 'added', 'id', 'line', 'lineid', 'me', 'my', 'ok', 'sticker',
        'official', 'already', 'done', 'chat', 'name', 'no', 'none', 'yes',
    ];

    public static function line(?string $v, array $ownIds = []): ?string
    {
        $v = trim((string) $v);
        if ($v === '') {
            return null;
        }
        $lower = mb_strtolower($v);
        if (in_array($lower, self::LINE_STOP, true) || in_array($lower, $ownIds, true)) {
            return null;                                  // คำทั่วไป หรือบัญชีของเราเอง
        }
        // ต้องดูเป็นไอดี ไม่ใช่ประโยค: ไม่มีช่องว่าง ความยาวพอเหมาะ
        return preg_match('/^@?[A-Za-z0-9._-]{4,20}$/', $v) === 1 ? $v : null;
    }
}
สังเกตว่า regex อย่างเดียวผ่านคำว่า added กับ sticker ได้สบาย เพราะทั้งสองคำยาวพอและเป็นตัวอักษรล้วน ถ้าไม่มี stop list ตัว regex "ดูเป็นไอดี" ก็ไม่ช่วยอะไรเลย สองชั้นต้องมาด้วยกัน
regex ว่าดูเป็นไอดี
- ผ่านคำอังกฤษทั่วไปเกือบทุกคำ
- ไม่รู้จักบริบทของบทสนทนา
- ตัวอย่างที่หลุด: added, sticker
ตรวจสองชั้น
- คำทั่วไปถูกกันก่อนตรวจรูปแบบ
- บัญชีของเราเองอยู่ใน stop list
- เพิ่มคำใหม่ได้โดยไม่แตะ regex
ตัวตรวจที่เหลือผมเขียนไว้ในคลาสเดียวกัน ได้แก่ phone() และ email() ที่ตรวจรูปแบบ split() ที่แยกช่องติดต่อที่ลูกค้าเขียนรวมกันเป็นข้อความเดียว และ scrub() ที่ตัดเลขบัตรประชาชนกับเลขเอกสารส่วนตัวอื่น ๆ ออกจากข้อความที่บอทจะเก็บ เพราะบอทไม่ควรเก็บเลขพวกนี้ลงฐานข้อมูลเลย ถึงลูกค้าจะพิมพ์มาเองก็ตาม อีกฟังก์ชันอ่านวันที่ที่ลูกค้าพิมพ์มาในข้อความ ซึ่งรองรับทั้งปี พ.ศ. และ ค.ศ. เพราะลูกค้าไทยพิมพ์ปีไม่เหมือนกัน
กฎเขียน: ไม่เขียนทับ และค่าที่ปฏิเสธไปอยู่ในข้อความเหตุการณ์
ตัวตรวจอย่างเดียวไม่พอ ต้องมีกฎตอนเขียนด้วย ผมเขียนกฎไว้ในตัวรับข้อมูลชื่อสมมติ ContactCapture สองข้อ
- ถ้าช่องในระเบียนมีค่าอยู่แล้ว ไม่เขียนทับ ค่าใหม่ที่ผ่านตัวตรวจไม่ได้สิทธิ์ทับของเดิม
- ถ้าค่าไม่ผ่านตัวตรวจ ไม่เก็บลงช่อง แต่ลงรายการค่าที่ปฏิเสธไว้ในข้อความเหตุการณ์ (event text) ของระเบียน พนักงานที่ตามดูจะเห็นว่าบอทเห็นค่าอะไรแล้วเลือกไม่เก็บ
<?php
// กฎเขียน: ตรวจก่อน, ไม่ทับของที่มี, ค่าที่ไม่ผ่านไปอยู่ในข้อความเหตุการณ์
function capture(Customer $c, array $raw, array $ownIds): array
{
    $clean = [
        'name'    => ContactNormalizer::name($raw['name'] ?? null),
        'phone'   => ContactNormalizer::phone($raw['phone'] ?? null),
        'email'   => ContactNormalizer::email($raw['email'] ?? null),
        'line_id' => ContactNormalizer::line($raw['line_id'] ?? null, $ownIds),
    ];
    $rejected = [];

    foreach ($clean as $field => $value) {
        if ($value === null) {
            if (!empty($raw[$field])) {
                $rejected[] = "$field=" . mb_substr((string) $raw[$field], 0, 40);
            }
            continue;                                    // ไม่ผ่าน = ไม่เก็บ
        }
        if (!empty($c->$field)) {
            continue;                                    // มีอยู่แล้ว = ไม่ทับ
        }
        $c->$field = $value;
    }

    if ($rejected) {
        $c->appendEvent('บอทเห็นแต่ไม่เก็บ: ' . implode(', ', $rejected));
    }
    $c->save();
    return $rejected;
}
กฎ "ไม่เขียนทับ" ดูเหมือนง่าย แต่มันตัดความเสียหายแบบที่เกิดสามครั้งตอนแรกทิ้งหมด ต่อให้ตัวตรวจพลาด ผ่านค่าผิดเข้ามาหนึ่งค่า ค่านั้นจะเข้าได้เฉพาะช่องที่ยังว่าง ข้อมูลเดิมที่เคยถูกต้องก็ไม่ถูกทำลาย นี่คือเหตุผลที่ผมมองกฎนี้เป็นตาข่ายชั้นที่สองมากกว่ากฎธุรกิจ ถ้าช่องเดิมผิดอยู่แล้ว ต้องมีคนไปแก้เอง ไม่ใช่ปล่อยให้ข้อความถัดไปมาเขียนทับแบบสุ่ม
รายละเอียดคำขอที่หายไป: เก็บไว้ก่อนมีระเบียน
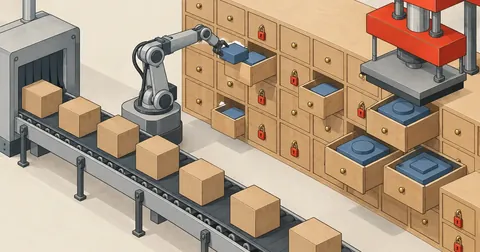
ข้อห้านั้นแยกออกมาเป็นปัญหาของตัวเอง ตอนข้อมูลมาถึง ระเบียนลูกค้ายังไม่ถูกสร้าง บอทเลยไม่มีที่ให้เก็บรายละเอียดคำขอ ข้อมูลส่วนนั้นหายไปเฉย ๆ ผมแก้โดยให้ ContactCapture เก็บรายละเอียดคำขอไว้ในพื้นที่พักก่อน พอระเบียนถูกสร้างค่อยแนบเข้าไป ผลคือต่อให้ลูกค้าให้ข้อมูลก่อนที่ระบบจะรู้จักเขา ข้อมูลนั้นก็ไม่หลุดหาย
แก้ข้อมูลเก่า: idempotent และ dump ก่อนเสมอ
ข้อมูลที่เสียไปแล้วต้องซ่อม ผมเขียนสคริปต์แก้ข้อมูลที่รันซ้ำได้ (idempotent) หมายความว่ารันกี่รอบก็ได้ผลลัพธ์สุดท้ายเหมือนกัน และรอบที่สองเป็นต้นไปต้องรายงานว่าเปลี่ยน 0 รายการ ถ้ารอบสองยังเปลี่ยนอยู่แปลว่าเงื่อนไขของสคริปต์ยังไม่นิ่ง
# ก่อนแก้ข้อมูลเก่า dump เต็มก่อนเสมอ
umask 077
mysqldump --single-transaction appdb | gzip > /var/backups/pre-fix-$(date +%Y%m%d-%H%M%S).sql.gz
<?php
// fix_crm.php: ซ่อมข้อมูลเก่าโดยใช้ตัวตรวจตัวเดียวกับที่ใช้ตอนเขียน
// ค่าเริ่มต้นเป็น dry-run ต้องใส่ --apply ถึงจะเขียนจริง
$apply = in_array('--apply', $argv, true);
$changes = 0;

foreach (Customer::cursor() as $c) {
    $fixed = ContactNormalizer::line($c->line_id, $ownIds);
    if ($c->line_id !== null && $fixed === null) {           // ค่าเดิมไม่ผ่านตัวตรวจ
        echo "[CHANGE] #{$c->id} line_id: " . json_encode($c->line_id) . " -> NULL\n";
        $changes++;
        if ($apply) {
            $c->line_id = null;
            $c->appendEvent('เคลียร์ LINE ID ที่ไม่ใช่ไอดี: ' . mb_substr($c->getOriginal('line_id'), 0, 40));
            $c->save();
        }
    }
    // ทำแบบเดียวกันกับ name / phone / email
}
echo "[" . ($apply ? 'APPLIED' : 'DRY-RUN') . "] changes=$changes\n";
รอบที่ผมรันจริง สคริปต์รายงาน 23 การเปลี่ยนแปลง หลังรันเสร็จผมรันซ้ำอีกครั้ง ต้องได้ changes=0 ถึงจะถือว่านิ่ง เพราะตัวเลขนี้พิสูจน์ว่าสคริปต์ใช้เกณฑ์เดียวกับตัวตรวจ และรอบแรกจัดการครบแล้ว
- dump ฐานข้อมูลเต็มก่อน เก็บไว้ในโฟลเดอร์ที่อ่านได้เฉพาะเจ้าของระบบ
- รันสคริปต์แบบ dry-run ดูรายการที่จะเปลี่ยนทีละบรรทัดด้วยตา
- รันแบบ apply แล้วบันทึกจำนวนการเปลี่ยน (รอบนั้นได้ 23)
- รันซ้ำอีกครั้ง ต้องได้ 0 ถ้าไม่ใช่ให้หยุดแล้วหาว่าเงื่อนไขไหนยังไม่นิ่ง
- ค่าเดิมที่ถูกเคลียร์ไปอยู่ในข้อความเหตุการณ์ของระเบียน ย้อนดูได้
เทสต์ที่ replay บทสนทนาที่เคยพลาด
บั๊กแบบนี้ซ้ำง่ายถ้าไม่มีเทสต์จับ ผมเลยเพิ่มเทสต์ใน WebChatTest ที่ replay บทสนทนาเดิมที่เคยทำให้ผิด แล้วเช็กว่าไม่มีช่องไหนถูกเขียน ผมใช้ชื่อและข้อความสมมติหมด ไม่ยกบทสนทนาจริงมาใส่เด็ดขาด ณ ตอนที่เขียนบทความนี้ชุดเทสต์ผ่านครบ 118 เทสต์
<?php
// เทสต์ replay: บทสนทนาที่เคยทำให้ LINE ID กลายเป็น "add" (ข้อความสมมติ)
public function test_line_add_phrase_does_not_become_line_id(): void
{
    $customer = Customer::factory()->create(['line_id' => 'real.id99']);

    $this->postChat($customer, [
        'ลูกค้า: ได้ line add ไปแล้วนะคะ',
        'ลูกค้า: ชื่อไลน์ Somchai ค่ะ',
    ]);

    $customer->refresh();
    $this->assertSame('real.id99', $customer->line_id);   // ไม่ถูกทับ
    $this->assertNotSame('ไลน์', $customer->name);        // คำช่องทางไม่ใช่ชื่อ
    $this->assertStringContainsString('บอทเห็นแต่ไม่เก็บ', $customer->events_text);
}
ทุกครั้งที่เจอบทสนทนาแบบใหม่ที่ทำให้บอทพลาด ผมเพิ่มเป็นเทสต์หนึ่งข้อทันที ตัวตรวจจะค่อย ๆ ฉลาดขึ้นตามบทสนทนาที่เคยพลาดจริง ซึ่งดีกว่าเดาล่วงหน้าว่าลูกค้าจะพิมพ์อะไรมา
ที่ผมเอาไปใช้ต่อ
ถ้าให้สรุปเป็นข้อ ๆ ผมถือห้าข้อนี้
- อย่าให้โมเดลหรือ regex เขียนฐานข้อมูลตรง ๆ ให้เซิร์ฟเวอร์ตรวจ
- ค่าที่ไม่ผ่านต้องรายงานแต่ไม่เก็บ และเก็บร่องรอยไว้ให้คนดู
- ไม่เขียนทับของที่มีอยู่แล้ว
- ทุกการแก้ข้อมูลเก่าต้อง idempotent และ dump ก่อนเสมอ
- เขียนเทสต์ replay บทสนทนาที่เคยพลาด
อีกเรื่องที่ผมแนะนำให้อ่านต่อคือ reimport-locked-fields-overrides-last ซึ่งเป็นแนวคิดคล้ายกันที่ฝั่งนำเข้าข้อมูล ว่าช่องที่คนแก้แล้วไม่ควรถูกเครื่องทับ ส่วนตัวผมคิดว่ากฎ "ไม่เขียนทับ" ควรมีติดไว้ทุกที่ที่เครื่องเขียนลงข้อมูลที่คนใช้งานต่อ ใครจะเพิ่มกฎอื่นเช่น ขอยืนยันกับลูกค้าก่อนเปลี่ยนช่องติดต่อก็ตามสะดวก ตรงไหนผมอธิบายตกหล่นหรือพิมพ์ผิด เดี๋ยวกลับมาแก้เพิ่มให้ภายหลังครับ
อยากให้เราทำให้ไหม?
ให้เราช่วยติดตั้ง ตั้งค่า ย้ายระบบ หรือแก้ปัญหาเซิร์ฟเวอร์ เพื่อให้คุณมีเวลาไปทำงานที่สำคัญกว่า
เคยเจองานแบบนี้ไหม? ติดตรงไหน?
มาแลกวิธีกันต่อในบอร์ด LinuxThai
ความคิดเห็น 0
ยังไม่มีความคิดเห็น — เป็นคนแรกเลย