ping ได้แต่ SSH หมดเวลา: โน้ตบุ๊กสองการ์ดเครือข่ายตอบกลับผิดเส้นทาง
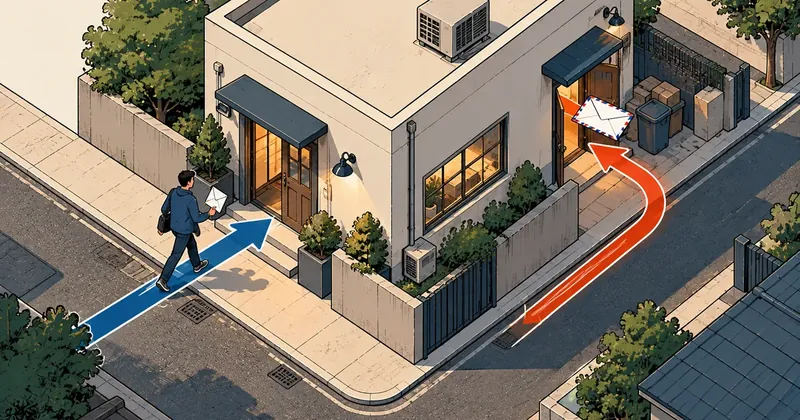
ไฟลิงก์ติดกับการมี IP ไม่ได้แปลว่าการ์ดนั้นใช้งานได้ และเครื่องที่มีสองการ์ดในวงเดียวกันอาจรับ SYN ทางหนึ่งแต่ตอบออกอีกทางหนึ่ง ทำให้ ping ผ่านแต่ SSH ไม่ผ่านเลย
สรุปใน 1 นาที
- อาการ/ปัญหา
- ping เครื่อง Debian ได้ แต่ SSH หมดเวลา เพราะ SYN เข้าทางหนึ่งแล้วตอบออกอีกทาง
- ใครควรอ่าน
- แอดมินที่มีเครื่องสองการ์ดเครือข่ายในวงเดียวกัน LAN กับ Wi-Fi
- ทางแก้แบบสั้น
- ตรวจด้วย ip route get ว่าตอบออกการ์ดไหน ทิ้ง route ของลิงก์ที่ดับ และทดสอบ TCP 22 จากภายนอกทุกครั้งที่ระบบเปลี่ยน route
พอดีผมจะ SSH เข้าเครื่อง Debian เครื่องหนึ่งที่ทำหน้าที่เซิร์ฟเวอร์ภายในวง LAN ของลูกค้ารายหนึ่ง แล้วค้างเงียบจนหมดเวลา ทั้งที่ ping เครื่องนั้นได้ตามปกติ สิ่งแรกที่ใครก็คิดคือ sshd ตาย หรือไฟร์วอลล์ปิดพอร์ต 22 แต่ ping ผ่านบอกว่าเครื่องยังอยู่ในเครือข่าย และเมื่อดูบนเครื่องเองก็ไม่มีอะไรผิดกับ sshd การดูข้างเดียวไม่เห็นปัญหาเลย ต้องวัดจากทั้งสองฝั่ง ทั้งจาก PC และจากเครื่องที่ต่อ Wi-Fi ถึงเริ่มเห็นภาพ บทความนี้เล่าว่าเกิดอะไรขึ้นกับเครื่องที่มีสองการ์ดเครือข่าย แล้วผมแยกสาเหตุอย่างไร ที่อยู่ทุกตัวในบทความเป็นตัวอย่างในช่วง 192.0.2.x ที่ผมเขียนใหม่
ส่วนที่ ping ยังผ่านขณะ SSH ไม่ผ่านนั้นผมสังเกตเห็นเอง แต่ผมไม่ได้พิสูจน์จากล็อกว่าทำไม ICMP ถึงรอดในสถานการณ์นี้ เลยจะไม่อธิบายสาเหตุของส่วนนั้นเกินกว่าที่เห็น ส่วนกลไก SYN เข้าทางหนึ่งตอบออกอีกทางหนึ่ง ดูได้จากตารางเส้นทางของเครื่องตรง ๆ
เครื่องนี้ตั้งค่าไว้อย่างไร
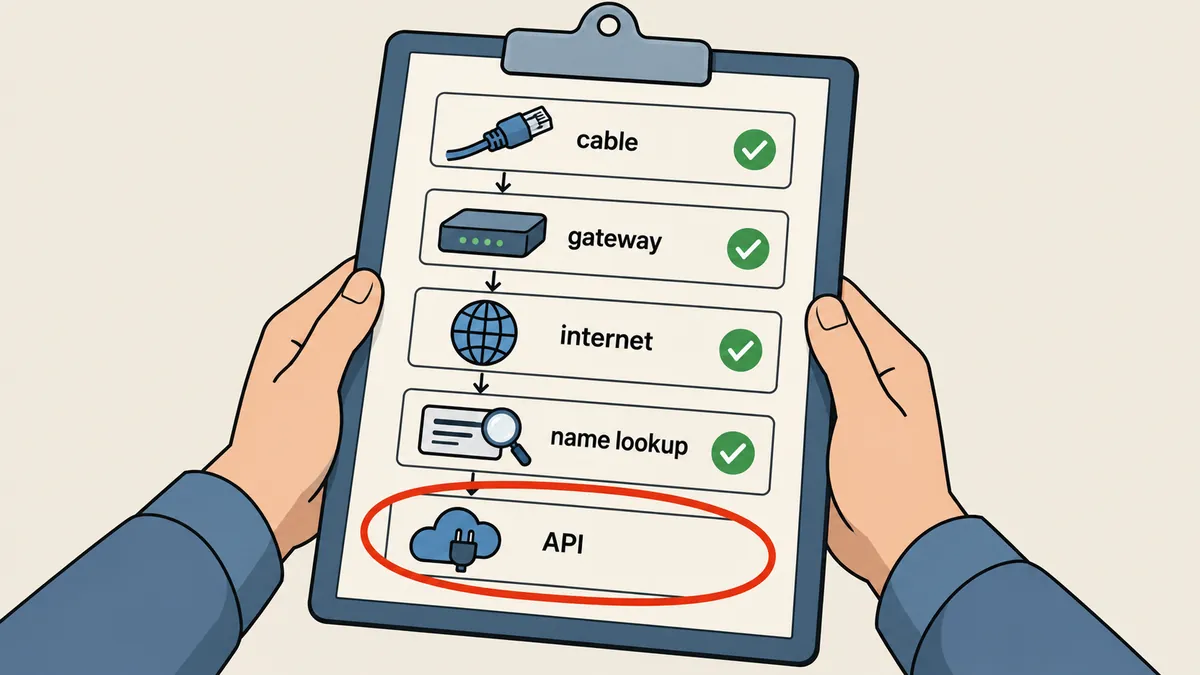
เครื่องนี้เป็นโน้ตบุ๊กที่ผมใช้เป็นเซิร์ฟเวอร์ ระบบเป็น Debian ใช้ ifupdown ไม่ใช่ NetworkManager (ตัวหลังอยู่ในสถานะ inactive) สายแลนเป็นเส้นหลักและได้ IP คงที่จากการจอง DHCP ที่เราเตอร์ ส่วน Wi-Fi เป็นเส้นสำรองใช้ DHCP รับที่อยู่อะไรก็ได้ เครื่องรัน self-heal ทุกนาที ตรวจ carrier, IPv4, ping gateway ต่อการ์ด, อินเทอร์เน็ต, DNS และ HTTPS ไปที่ API ของบริการแชทที่เครื่องนี้ต้องคุยด้วย แล้วใช้ ip route get ดูว่า default route จริง ๆ ออกทางการ์ดไหน
ที่อยู่ของสองการ์ดอยู่ในวง /24 เดียวกัน สมมติว่าสายคือ 192.0.2.10 และ Wi-Fi คือ 192.0.2.11 โดยมี gateway เป็น 192.0.2.1 ตรงนี้ไม่ผิดอะไรในตัวมันเอง แต่ทำให้ลินุกซ์มีสองทางเลือกที่ใช้ได้พอ ๆ กันในการคุยกับวงเดียวกัน และเมื่อเกิดความผิดปกติ ปัญหาก็แสดงออกมาแปลกกว่าการ์ดเดียว
เหตุการณ์: สายมีไฟ มี IP แต่ถึง gateway ไม่ได้
วันที่เกิดเรื่อง สายแลนของเครื่องมีไฟลิงก์ติด และการ์ดก็ยังมี IP ครบ ทุกอย่างบนหน้าจอเหมือนปกติ แต่ที่จริงสายนั้นถึง gateway ไม่ได้ (ผมมารู้ภายหลังตอนเปลี่ยนสาย) self-heal ที่วัดถึง gateway ต่อการ์ดเห็นว่าสายใช้ไม่ได้ ก็ทำตามที่ออกแบบไว้ คือย้าย default route ไปที่ Wi-Fi เพื่อให้เครื่องออกอินเทอร์เน็ตได้ต่อ แต่มีสิ่งหนึ่งที่มันไม่ได้ทำ คือเอา IP ของสายออกจากการ์ด
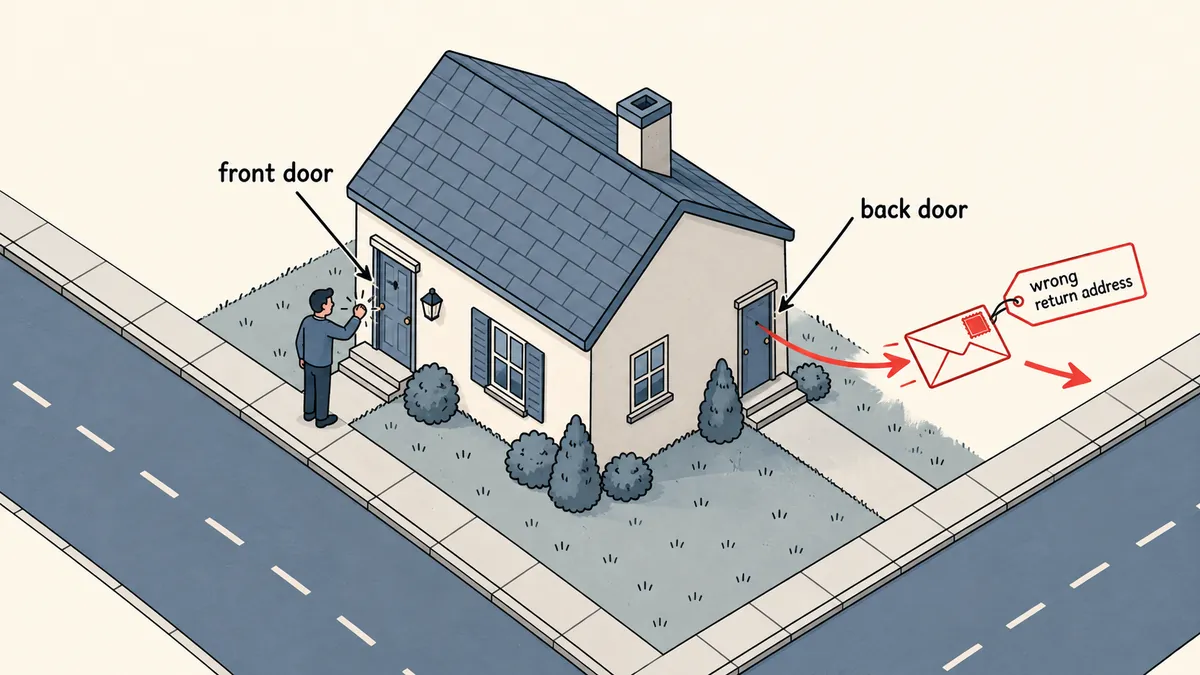
ผลก็คือเครื่องยังเป็นเจ้าของ 192.0.2.10 บนการ์ดสาย ขณะที่ default route ชี้ออกทาง Wi-Fi ไคลเอนต์ที่ SSH มาที่ .10 ส่ง SYN ไปถึงการ์ดสายได้ (ผมไม่ได้เจาะลึกว่าทำไมขาเข้าของสายยังผ่านทั้งที่ขาออกถึง gateway ไม่ได้ เลยขอเล่าเท่าที่เห็น) แต่เมื่อเครื่องจะตอบ SYN-ACK มันเปิดตารางเส้นทางแล้วเห็นว่าขาออกต้องไปทาง Wi-Fi ตามที่ default route บอก โดยใช้ source address ของ .10 ซึ่งเป็นที่อยู่ของอีกการ์ด คำตอบนี้ออกไปคนละเส้นทางกับที่คำขอเข้ามา ฝั่งไคลเอนต์ไม่เคยได้ SYN-ACK ที่ตรงกับ session ของมัน TCP 22 เลยหมดเวลา
เรื่องนี้เรียกว่า asymmetric routing คือเส้นทางไปกับเส้นทางกลับไม่ใช่เส้นเดียวกัน เครือข่ายที่มีการ์ดเดียวไม่เจอเพราะขาออกมีทางเดียวเสมอ ส่วนเครื่องที่มีสองการ์ดในวงเดียวกันเจอได้ทันทีที่ default route ไม่ตรงกับการ์ดที่รับแพ็กเก็ตเข้ามา
บันไดการวินิจฉัยที่ใช้ได้ผล
เพราะอาการแบบนี้ดูข้างเดียวไม่เห็น ผมใช้บันไดสี่ขั้น ไล่จากถูกที่สุดไปแพงที่สุด ขั้นแรก ping gateway ต่อการ์ดโดยระบุการ์ดตรง ๆ เพื่อดูว่าแต่ละการ์ดถึง gateway จริงไหม ขั้นสองดูว่าเส้นทางจริงที่เครื่องจะเลือกไปหาไคลเอนต์คือการ์ดไหน ขั้นสามเทียบผลจากฝั่ง PC ที่ต่อสายกับเครื่องที่ต่อ Wi-Fi ขั้นสุดท้ายคือเปลี่ยนสายแล้ววัดซ้ำ
# 1) ถึง gateway ไหมต่อการ์ด (ping -I บังคับการ์ด)
ping -c 3 -I lan0  192.0.2.1
ping -c 3 -I wlan0 192.0.2.1

# 2) เส้นออกจริงตอนตอบไคลเอนต์คือการ์ดไหน และใช้ source อะไร
ip route get 192.0.2.50
ip route show default
ip -br addr

# 3) เทียบจากสองฝั่งที่ต่างกัน (รันบนไคลเอนต์ทีละเครื่อง)
ssh -o ConnectTimeout=5 [email protected] true; echo "exit=$?"
ssh -o ConnectTimeout=5 [email protected] true; echo "exit=$?"
ใน ip route get ให้ดูสองคำคือ dev กับ src ถ้า dev เป็น wlan0 แต่ผู้ที่เรียกมาเข้าที่ .10 แสดงว่าเข้ากับออกคนละทาง ส่วนข้อ 3 ให้เทียบสองที่อยู่ ถ้า SSH ไปที่ .11 (ที่อยู่ของ Wi-Fi) ผ่านได้ขณะที่ .10 ไม่ผ่าน นั่นบอกว่าตัวเครื่องและ sshd ไม่มีปัญหา ปัญหาอยู่ที่เส้นทางของสาย ระหว่างนั้นผมเลยทำ alias ssh สองอัน อันปกติกับอัน -lan ชี้ไปที่อยู่ที่ถึงได้ในขณะนั้น จะได้เข้าไปทำงานต่อได้ก่อนเปลี่ยนสาย
เรื่องที่เกี่ยวกัน: สองการ์ดในวงเดียวกันกับ ARP
ผมมีโน้ตจากอีกเหตุการณ์ของเครื่องแบบเดียวกัน ตอนนั้นทั้งสายและ Wi-Fi อยู่ในวง /24 เดียวกัน (สมมติว่า .10 กับ .11) และค่า arp_ignore ตามค่าปริยายของเคอร์เนลทำให้ทั้งสองการ์ดตอบ ARP แทนกันได้ ตารางของเราเตอร์เลยเห็นว่าทั้งสอง MAC ใช้ IP เดียว และคำตอบไปหาไคลเอนต์ที่ต่อ Wi-Fi หาย ขณะที่เครื่องที่ต่อสายยังเข้าได้ตามปกติ ผมแก้บนเครื่องโดยตั้ง arp_ignore ให้แต่ละการ์ดตอบเฉพาะ IP ของตัวเอง ส่วนตัวเลขค่าที่ตั้งจริง ผมไม่ได้เปิดยืนยันซ้ำก่อนเขียนบทความนี้ เลยไม่ระบุตัวเลข ใครจะตั้งให้ดูเอกสารเคอร์เนลของ arp_ignore กับ arp_announce และอ่านค่าปัจจุบันของเครื่องตัวเองก่อนแก้เสมอ
# อ่านค่าปัจจุบันก่อนแก้อะไร
sysctl net.ipv4.conf.all.arp_ignore net.ipv4.conf.all.arp_announce
sysctl net.ipv4.conf.lan0.arp_ignore net.ipv4.conf.wlan0.arp_ignore
ปัญหา ARP กับปัญหา route ตอบผิดเส้นเป็นคนละเรื่อง แต่มีรากเดียวกันคือเครื่องหนึ่งเครื่องมีหลายที่อยู่ในวงเดียวกัน อาการที่ออกมาแปลกทั้งคู่ และ ping ที่ผ่านไม่ได้พิสูจน์ว่าทางนั้นใช้ได้ทั้งหมด
มาตรการที่เครื่องทำเอง
หลังเจอเหตุการณ์นี้ ผมปรับสองอย่าง ข้อแรกคือ sysctl ให้เคอร์เนลไม่ใช้ route ที่ลิงก์ดับ เพื่อให้ default route ที่ผูกกับการ์ดสายซึ่งลิงก์ลงไปแล้วไม่ค้างอยู่ในตาราง
# /etc/sysctl.d/90-net.conf
net.ipv4.conf.all.ignore_routes_with_linkdown = 1
net.ipv4.conf.default.ignore_routes_with_linkdown = 1
net.ipv6.conf.all.ignore_routes_with_linkdown = 1
net.ipv6.conf.default.ignore_routes_with_linkdown = 1
ข้อที่สองคือ self-heal คืนสายเป็นเส้นหลักเมื่อลิงก์กลับมา (ifdown --force แล้ว ifup เว้นอย่างน้อย 120 วินาที) แต่ถ้าสายมีลิงก์ทว่าไม่มีอินเทอร์เน็ตผ่านสาย มันจะถอยกลับไปใช้ Wi-Fi แล้วลองสายใหม่อีกทีในสิบนาที ส่วนกรณี "gateway ตอบแต่ไม่มีอินเทอร์เน็ต" ผมถือว่าเป็นฝั่ง ISP ล่ม ไม่ทำอะไรกับเครื่อง เรื่องบันไดการกู้ทั้งหมดของ self-heal ผมเล่าไว้ละเอียดแล้วใน แยกลิงก์พังกับ ISP ล่มก่อน restart ตรงนี้ขอสรุปเป็นตารางสั้น ๆ
| อาการที่เห็นติดกัน | สิ่งที่ self-heal ทำ |
|---|---|
| DNS พัง | เขียน resolv.conf ใหม่ |
| การ์ดไม่มี IPv4 (2 รอบ) | ifdown แล้ว ifup |
| Wi-Fi ตาย (3 รอบ) | ifup แล้ว restart wpa_supplicant |
| ถึง gateway ไม่ได้ทุกการ์ด (6 รอบ) | restart networking |
| ไม่ฟื้นภายใน 40 นาที | รีบูต สูงสุดหนึ่งครั้งต่อ 6 ชั่วโมง |
มันแจ้งเตือนเฉพาะเหตุขัดข้องที่ยาวตั้งแต่ 15 นาทีขึ้นไป พร้อมสรุปสาเหตุสั้น ๆ ที่โมเดลเล็กเขียนให้จากล็อกที่ส่งเข้าไป โดยไม่ให้โมเดลใช้เครื่องมือใด ๆ
เหตุการณ์นี้เกิดจากการแก้ที่ถูกต้องตามตรรกะ คือย้าย default ไปเส้นที่ใช้ได้ แต่ผลข้างเคียงทำให้เข้าเครื่องจากภายนอกไม่ได้ ทุกครั้งที่ระบบอัตโนมัติเปลี่ยน route ต้องมีใครสักคนหรือเครื่องอื่นทดสอบว่าเข้าเครื่องนี้ได้จริงจากข้างนอก ไม่ใช่ดูจากข้างในว่าออกเน็ตได้
netprobe: ตัวแยกว่าเน็ตหายเพราะอะไร
ส่วนที่สองที่ผมทำเพิ่มคือ netprobe สคริปต์ที่ทุกนาทีบันทึก CSV หนึ่งบรรทัดว่าเครือข่ายตอนนั้นเป็นอย่างไร ค่าที่วัดคือ ping ถึง gateway และ public resolver สองตัว (เป็นมิลลิวินาที) การ resolve ชื่อ การเข้าถึง API ของบริการแชท host ของ API โมเดล เว็บของผู้ให้บริการ ตัวบ่งชี้จากหน้า status และจำนวนบรรทัดที่มีคำว่า 529 หรือ overloaded หรือ timeout ในล็อกของบอท 2 นาทีล่าสุด จากนั้นให้ป้ายสาเหตุเพียงอันเดียว ไม่ต้องเดา
# ตัวอย่างลำดับตัดสินแบบย่อ (ของจริงมีค่าที่วัดมากกว่านี้)
def classify(m):
    if not m["gw_ok"]:                      return "lan"
    if not (m["r1_ok"] or m["r2_ok"]):      return "isp"
    if not m["dns_ok"]:                     return "dns"
    if not m["chat_api_ok"]:                return "chat"
    if m["provider_down"] or m["overloaded_lines"] > 0:
                                            return "provider"
    return "ok"

# แจ้งเมื่อป้ายเดิมซ้ำ 2 รอบติด และแจ้งตอนหายพร้อมระยะเวลา
def should_alert(history):
    return len(history) >= 2 and history[-1] == history[-2] != "ok"
ถ้าป้ายเป็น lan หรือ isp ผมปล่อยให้ self-heal จัดการเอง netprobe แค่เขียนผลล่าสุดลง /run/netprobe/last.json เพื่อให้ self-heal ยกสาเหตุที่วัดได้ไปใส่ในข้อความแจ้งเตือน และมีโหมด --report สรุปว่าใน 24 ชั่วโมงที่ผ่านมาล่มกี่นาทีต่อสาเหตุ
มีข้อสังเกตหนึ่งที่ผมเขียนเป็นข้อสังเกตเท่านั้น ไม่ใช่ข้อสรุป คือบางครั้งที่ดูเหมือนเน็ตหลุด ตัวที่มีปัญหาจริงคือผู้ให้บริการ API โอเวอร์โหลด ไม่ใช่เครือข่ายของเรา ผมสงสัยว่าเรื่องนี้เกี่ยวกับประวัติแชทที่ยาวขึ้น แต่พิสูจน์จากไฟล์ที่มีอยู่ไม่ได้ เลยขอเก็บไว้เป็นข้อสังเกตเท่านั้น
ทางแก้ที่รู้จัก แต่ผมไม่ได้ใช้กับเครื่องนี้
มีวิธีมาตรฐานของลินุกซ์ที่ทำให้เครื่องหลายการ์ดตอบกลับออกทางการ์ดเดียวกับที่รับเข้ามา เรียกว่า policy routing คือสร้างตารางเส้นทางแยกต่อการ์ด แล้วตั้งกฎว่าแพ็กเกจที่มี source เป็นที่อยู่ของการ์ดไหนให้ใช้ตารางของการ์ดนั้น ผมเขียนตัวอย่างไว้ให้ดูเฉย ๆ เพราะเครื่องนี้ผมเลือกแก้ด้วยการเก็บ route ให้ถูก (ทิ้ง route ที่ลิงก์ดับ และคืนสายเมื่อกลับมา) ไม่ได้ลองวิธีนี้กับเครื่องนี้จริง ใครจะใช้ให้ทดสอบกับเครื่องที่ยังมีทางเข้าสำรองก่อน
วิธีที่ผมใช้กับเครื่องนี้
ให้ default route ตามเส้นหลักที่ใช้ได้จริงเสมอ และไม่ปล่อย route ของการ์ดที่ลิงก์ดับค้างอยู่ ข้อดีคือกฎน้อย อ่านง่าย ข้อเสียคือต้องพึ่ง self-heal ให้ทำงานถูกตลอด
ตอบออกการ์ดเดียวกับที่รับเข้า
ตั้งตารางเส้นทางแยกต่อการ์ดกับกฎตาม source ข้อดีคือทนต่อ default route ที่ไม่ตรง ข้อเสียคือมีกฎเพิ่ม และต้องดูแลให้ตรงกับที่อยู่ที่เปลี่ยนได้
# ตัวอย่างแนวคิดเท่านั้น (192.0.2.x) ยังไม่ได้ทดสอบกับเครื่องนี้
echo "100 lan"  >> /etc/iproute2/rt_tables
ip route add 192.0.2.0/24 dev lan0 src 192.0.2.10 table lan
ip route add default via 192.0.2.1 dev lan0 table lan
ip rule add from 192.0.2.10/32 table lan
ทดสอบการเข้าถึงจากภายนอก ทุกครั้งที่ระบบอัตโนมัติแตะ route
ข้อเตือนที่ผมย้ำกับตัวเองที่สุดจากเหตุการณ์นี้คือ ระบบที่แก้ตัวเองได้ต้องมีคนตรวจจากข้างนอกด้วย ตอนที่ self-heal ย้าย route ไป Wi-Fi เครื่องออกอินเทอร์เน็ตได้ผ่าน Wi-Fi ซึ่งก็จริงสำหรับขาออก แต่ไม่มีด่านไหนถามว่าขาเข้ายังเข้าได้ไหม วิธีที่ง่ายที่สุดคือให้เครื่องอื่นในวงเดียวกัน (หรือเครื่องที่ผมใช้ดูแล) ลองต่อ TCP 22 ของเครื่องนี้เป็นระยะแล้วเก็บผลไว้ ถ้าต่อไม่ได้ขณะที่ ping ผ่าน ก็ได้ป้ายใหม่อีกอันที่คุ้มเกินราคาของมัน
# รันจากเครื่องอื่นในวงเดียวกัน ทุกนาทีด้วย cron หรือ timer
timeout 5 bash -c '</dev/tcp/192.0.2.10/22' && echo "tcp22 ok" || echo "tcp22 FAIL"
ping -c 1 -W 2 192.0.2.10 >/dev/null && echo "icmp ok" || echo "icmp FAIL"
เมื่อสองบรรทัดนี้ให้ผลต่างกัน (icmp ok แต่ tcp22 FAIL) นั่นคือลายนิ้วมือของอาการในบทความนี้ ไม่ต้องเสียเวลาไปไล่ดู sshd
บทเรียนสี่ข้อ
- ไฟลิงก์ติดและมี IP ไม่ได้แปลว่าใช้งานได้ ต้องวัดถึง gateway ต่อการ์ดทุกครั้ง
- อย่าทิ้ง IP ของการ์ดที่ไม่ใช่เส้นหลักไว้โดยไม่ปรับ route หรือ ARP เพราะจะได้เครื่องที่รับแพ็กเก็ตได้ทางหนึ่งแต่ตอบออกอีกทาง
- ทดสอบการเข้าถึงจากภายนอกเครื่องทุกครั้งที่ self-heal เปลี่ยน route
- ป้ายสาเหตุที่วัดได้ ลดการเดาตอนจะรีสตาร์ตอะไรสักอย่าง
ส่วนตัวผมจะไม่เลือกให้เครื่องที่ต้องรับงานเข้ามีสองการ์ดในวงเดียวกันอีก ถ้าไม่จำเป็น ใช้สายอย่างเดียวและมีเครื่องสำรองแยกต่างหากจะเรียบง่ายกว่ามาก แต่ถ้าต้องมีสองการ์ดจริง ต้องจัด route กับ ARP ให้ถูกตั้งแต่แรก ตามความจำเป็นของแต่ละงานครับ ตรงไหนผมอธิบายสั้นเกินไปหรือพลาด เดี๋ยวกลับมาแก้เพิ่มให้ภายหลังครับ
อยากให้เราทำให้ไหม?
ให้เราช่วยติดตั้ง ตั้งค่า ย้ายระบบ หรือแก้ปัญหาเซิร์ฟเวอร์ เพื่อให้คุณมีเวลาไปทำงานที่สำคัญกว่า
เคยเจองานแบบนี้ไหม? ติดตรงไหน?
มาแลกวิธีกันต่อในบอร์ด LinuxThai
ความคิดเห็น 0
ยังไม่มีความคิดเห็น — เป็นคนแรกเลย