อัปเกรด Proxmox 3 node พร้อมกัน เครื่องเดียวช้าเพราะ locale 509 ชุด
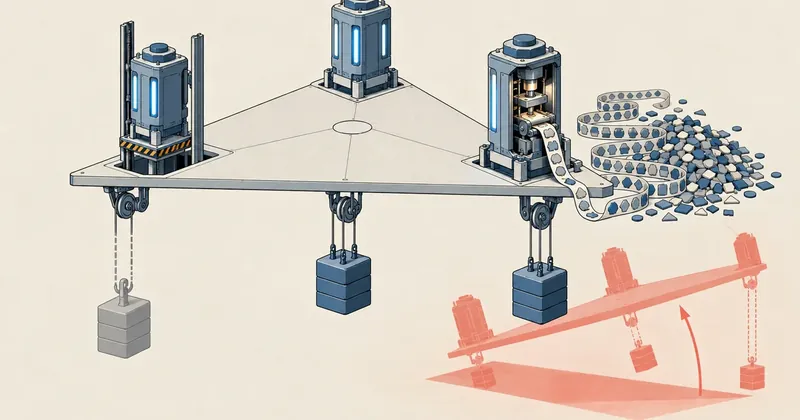
คลัสเตอร์สามเครื่องทนเครื่องหายได้ทีละเครื่องเท่านั้น และกติกาข้อนี้ยังใช้อยู่แม้ในคืนที่เราเป็นคนสั่งให้มันหายเอง การอัปเกรดที่ปลอดภัยเลยไม่ได้อยู่ที่คำสั่ง apt แต่อยู่ที่ลำดับของการ reboot และการรู้ว่าเครื่องที่ช้านั้นช้าหรือค้าง
สรุปใน 1 นาที
- อาการ/ปัญหา
- อัปเกรด Proxmox 3 node พร้อมกัน สองเครื่องเสร็จใน 5 นาที อีกเครื่องดูเหมือนค้าง
- ใครควรอ่าน
- คนดูแล Proxmox cluster สามเครื่องที่ต้อง dist-upgrade
- ทางแก้แบบสั้น
- เครื่องที่ช้าแค่กำลังคอมไพล์ locale 509 รายการ ไม่ได้ค้าง ให้ reboot ทีละเครื่อง เพื่อให้เหลือ 2 ใน 3 ยืนอยู่เสมอ
พอดีผู้ใช้ปลายทาง remote เข้า VM บนคลัสเตอร์ Proxmox 3 node ของผมไม่ได้ เจ้าของตัดสินใจว่าไหน ๆ ก็ต้องแตะแล้ว ให้อัปเดตทั้งคลัสเตอร์ไปเลย สั่งมาสั้น ๆ ว่าหยุด VM ทั้งหมดแล้ว apt update upgrade ทั้ง 3 เครื่อง ผมปล่อยสคริปต์พร้อมกันสามเครื่องตอน 19:04 สองเครื่องจบภายในห้านาที เครื่องที่สามเงียบไปนานจนเจ้าของถามว่าทำไมช้า ปกติเร็ว แล้วก็ตามด้วยคำถามที่สำคัญกว่า reboot สองเครื่องที่เสร็จแล้วไปก่อนไม่ได้เหรอ
ในบทความนี้ผมเรียกสามเครื่องว่า node A, B, C โดย B คือเครื่องที่ช้า เลขรุ่นของซอฟต์แวร์ผมไม่ลง บอกแค่ว่าเป็นการอัปจากรุ่นย่อยก่อนหน้าไปรุ่นย่อยล่าสุดของสายเดียวกัน ทั้งตัวจัดการและ kernel ไม่ใช่การข้ามรุ่นใหญ่แบบที่เล่าไว้ใน ใช้ Claude อัป Proxmox 8 ขึ้น 9 แล้วสร้าง Windows VM ใหม่ทั้งคลัสเตอร์ เวลา จำนวนแพ็กเกจ และตัวเลขที่วัดเป็นของจริง
ก่อนอัปเกรด: RAM 100.70% ที่ไม่ใช่ปัญหา
ก่อนจะถึงเรื่องอัปเกรด มีการเดาผิดหนึ่งครั้งที่ควรเล่า หน้า summary ของ VM ตัวหนึ่งโชว์ RAM 100.70% ดูแล้วเหมือนแรมหมดจน remote ไม่เข้า แต่ตัวเลขนี้ไม่ได้มาจากใน guest VM ตัวนั้นปิด balloon ไว้ (balloon: 0) และ guest agent ไม่ได้รัน Proxmox เลยไม่มีตัวเลขการใช้แรมจากข้างใน สิ่งที่มันเอามาแสดงแทนคือ RSS ของ process kvm บนโฮสต์ ซึ่งรวม overhead ของการจำลองอุปกรณ์เข้าไปด้วย เลยเกิน 100% ของแรมที่จัดให้ VM ได้
ฝั่งโฮสต์ยืนยันว่าไม่มีแรงกดดันเรื่องหน่วยความจำเลย
free -g | sed -n 2p            # Mem: รวม 32 GB ใช้ 16.8 GB available 15.1 GB
cat /proc/pressure/memory
# some avg10=0.00 avg60=0.00 avg300=0.00 total=...
# full avg10=0.00 avg60=0.00 avg300=0.00 total=...
dmesg -T | grep -ci 'out of memory'    # 0
uptime                                  # load average 0.44
เปอร์เซ็นต์ในหน้า summary ของ VM ที่ปิด balloon และไม่มี guest agent คือขนาดของ process kvm ไม่ใช่การใช้งานใน guest ตัวที่บอกว่าเครื่องกำลังขาดแรมจริงคือ /proc/pressure/memory ถ้าทุกค่าเป็น 0.00 และไม่มี OOM ใน log แปลว่ายังไม่มีอะไรต้องรอแรม
ส่วนสาเหตุจริงที่ remote ไม่ได้นั้นธรรมดากว่ามาก ผู้ใช้ยิงไปผิด IP เป็นเลขที่ไม่มีเครื่องไหนในวงถืออยู่ ไม่เกี่ยวกับแรมและไม่เกี่ยวกับรุ่นของ Proxmox แต่ตอนนั้นเจ้าของตัดสินใจอัปเดตไปแล้ว งานเลยเดินต่อ
สคริปต์อัปเกรดต่อ node: ตรวจก่อน หยุด guest แล้วค่อย dist-upgrade
แต่ละ node รันสคริปต์ตัวเดียวกันแบบ detach เขียน log ลงไฟล์ และจบด้วยไฟล์ marker ที่บอกผลเป็นคำเดียว เหตุผลที่ต้อง detach คือถ้า SSH หลุดกลางทาง dpkg ต้องไม่ตายตามไปด้วย
#!/bin/bash
# /root/pve-upgrade.sh -- เรียกด้วย: nohup /root/pve-upgrade.sh >/dev/null 2>&1 &
LOG=/root/pve-upgrade.log
MARK=/root/pve-upgrade.marker
exec >>"$LOG" 2>&1
rm -f "$MARK"
fail() { echo "DONE-FAIL $*" | tee "$MARK"; exit 1; }

# 1) จดว่า guest ตัวไหนกำลังรัน
{ qm list  | awk '$3=="running"{print "qm",  $1}'
  pct list | awk '$2=="running"{print "pct", $1}'; } > /root/running-before-upgrade.txt

# 2) พื้นที่ไม่พอ = หยุด ไม่อัปเกรด (กัน kernel ลงไม่ครบ)
root_kb=$(df -k --output=avail /     | tail -1)
boot_kb=$(df -k --output=avail /boot | tail -1)
[ "$root_kb" -gt $((2 * 1024 * 1024)) ] || fail "/ เหลือไม่ถึง 2 GB"
[ "$boot_kb" -gt $((200 * 1024)) ]      || fail "/boot เหลือไม่ถึง 200 MB"

# 3) หยุด guest ทุกตัว
for id in $(qm list | awk '$3=="running"{print $1}'); do
  echo "qm stop $id"
  qm stop "$id" --timeout 90 || qm stop "$id" --skiplock 1
done
for id in $(pct list | awk '$2=="running"{print $1}'); do
  echo "pct stop $id"; pct stop "$id"
done

# 4) โชว์รายการก่อน  5) dist-upgrade เก็บ config เดิม
export DEBIAN_FRONTEND=noninteractive
apt-get update || fail "apt update"
apt list --upgradable 2>/dev/null
apt-get -y -o Dpkg::Options::=--force-confold dist-upgrade || fail "dist-upgrade"

# 6) ต้อง reboot ไหม แล้วเก็บกวาด
newest=$(ls -1 /boot/vmlinuz-* | sort -V | tail -1 | sed 's|/boot/vmlinuz-||')
[ "$(uname -r)" != "$newest" ] && echo "REBOOT-NEEDED running=$(uname -r) newest=$newest"
apt-get -y autoremove
echo "DONE-OK $(date +%T)" | tee "$MARK"
มีสามจุดที่ผมตั้งใจใส่ จุดแรกใช้ dist-upgrade ไม่ใช่ upgrade เฉย ๆ เพราะแพ็กเกจของ Proxmox เปลี่ยน dependency ข้ามรอบอยู่เรื่อย ๆ upgrade ธรรมดาจะกั๊กแพ็กเกจที่ต้องติดตั้งตัวใหม่เพิ่มไว้ ได้ระบบครึ่งเก่าครึ่งใหม่ จุดที่สอง --force-confold ให้เก็บไฟล์ config เดิมไว้เสมอเมื่อแพ็กเกจมีไฟล์รุ่นใหม่มาด้วย ไม่ต้องมีใครมานั่งตอบคำถามกลางสคริปต์ จุดที่สามคือการตรวจพื้นที่ก่อน ถ้า /boot เต็มระหว่างลง kernel จะได้ kernel ที่ลงไม่ครบ ซึ่งแก้ยากกว่าการไม่อัปเกรดเลย
ตัวคุมฝั่งเครื่อง admin ทำหน้าที่อย่างเดียวคือเฝ้า marker ของทั้งสามเครื่อง ถ้ามี node ใดขึ้น DONE-FAIL จะไม่ reboot ทั้งชุดและดึง log 20 บรรทัดท้ายของเครื่องนั้นมาให้ดู รอ upgrade ไม่เกิน 80 นาที รอ reboot แต่ละเครื่องไม่เกิน 15 นาที
สองเครื่องจบในห้านาที อีกเครื่องยังไม่จบ
เริ่มพร้อมกัน 19:04 node C เสร็จ 19:08:39 อัปไป 221 แพ็กเกจ node A เสร็จ 19:09:44 อัปไป 252 แพ็กเกจ ส่วน node B ยังไม่มี marker เจ้าของถามว่าทำไมช้า ปกติเร็ว ซึ่งเป็นคำถามที่ถูก เพราะสามเครื่องเริ่มพร้อมกันและอัปจากคลังเดียวกัน
สิ่งแรกที่ต้องตอบให้ได้ก่อนจะทำอะไรต่อคือ มันช้า หรือมันค้าง สองอย่างนี้ต้องการการตัดสินใจตรงข้ามกัน ถ้าช้าต้องรอ ถ้าค้างต้องเข้าไปแก้ และการไปฆ่า dpkg ที่แค่ช้าคือวิธีทำให้เครื่องที่ดีอยู่กลายเป็นเครื่องที่มีแพ็กเกจค้างครึ่งทาง
แยกช้าออกจากค้าง: locale-gen 509 รายการ
ผมดูสามอย่างตามลำดับ process ยังอยู่ไหม มีตัวนับอะไรที่เดินไหม และมีไฟล์ไหนที่โตขึ้นไหม
# 1) process ยังอยู่ไหม และรันมานานแค่ไหน (วินาที)
ps -eo pid,etimes,cmd | grep -E 'apt-get|dpkg|locale-gen|localedef' | grep -v grep
#  ... 186 /bin/sh /usr/sbin/locale-gen

# 2) เปิด locale ไว้กี่รายการ และคอมไพล์ไปแล้วกี่รายการ
grep -cvE '^(#|$)' /etc/locale.gen       # 509   (อีกสองเครื่องได้ 1)
localedef --list-archive | wc -l          # 354 -> อีก 40 วินาทีได้ 405

# 3) ไฟล์ archive โตไหม
ls -l /usr/lib/locale/locale-archive      # 141 MB -> 161 MB
dpkg กับ apt-get ยังอยู่ และตัวที่กำลังกินเวลาคือ locale-gen ซึ่งรันมาแล้ว 186 วินาที postinst ของแพ็กเกจ locales จะคอมไพล์ locale ทุกรายการที่เปิดไว้ใน /etc/locale.gen ใหม่ทั้งหมดทุกครั้งที่แพ็กเกจถูกอัปเดต node B เปิดไว้ 509 รายการ ส่วน A กับ C เปิดไว้ 1 รายการ งานที่อีกสองเครื่องทำรอบเดียว เครื่องนี้ต้องทำ 509 รอบ
ตัวนับเดินจาก 354 ไป 405 ใน 40 วินาที เท่ากับ 1.27 locale ต่อวินาที ไฟล์ locale-archive โตจาก 141 MB เป็น 161 MB ทั้งสามสัญญาณบอกตรงกันว่ามันทำงานอยู่ ไม่ได้ค้าง และพอมีอัตรา ก็ประมาณเวลาที่เหลือได้ ตอนที่นับได้ 405 ยังเหลืออีกราว 100 รายการ คือไม่ถึงสองนาที ช่วงแรกช้ากว่านี้เพราะ locale ที่มีตารางอักขระใหญ่อย่างภาษาจีนอยู่ต้นลำดับตัวอักษร พอพ้นกลุ่มนั้นไปอัตราก็ขึ้น ตอนจบนับใน archive ได้ 513 รายการ และ node B อัปไปทั้งหมด 234 แพ็กเกจ
ต้องรอ ห้ามแตะ
process ของ dpkg ยังอยู่ ตัวนับใน localedef --list-archive เพิ่มขึ้นเมื่อดูซ้ำ ไฟล์ locale-archive โตขึ้น คำนวณอัตราแล้วประมาณเวลาจบได้ การฆ่า process ตอนนี้ทำให้แพ็กเกจค้างสถานะ configure ไม่เสร็จ
ต้องเข้าไปดู
process ยังอยู่แต่ตัวนับไม่ขยับในหลายรอบของการวัด ไฟล์ไม่โต ไม่มี I/O หรือ process หายไปแล้วแต่ไม่มี marker อย่างหลังนี้ต้องอ่าน log ท้ายไฟล์แล้วสั่ง dpkg --configure -a ต่อ
ผมไม่ได้ไล่ต่อว่า 509 รายการนั้นถูกเปิดไว้ตั้งแต่เมื่อไหร่ และ ณ วันที่เขียนยังไม่ได้ลดจำนวนลง แต่สิ่งที่จะทำก่อนรอบอัปเดตครั้งหน้าคือเปิดดู /etc/locale.gen ของทุกเครื่องให้เหลือเฉพาะที่ใช้จริง ไม่อย่างนั้นทุกครั้งที่แพ็กเกจ locales ขยับ เครื่องนี้จะเสียเวลาแบบเดิมอีก
reboot ทีละเครื่อง ให้มี 2 ใน 3 ยืนเสมอ
คำถามว่า reboot สองเครื่องที่เสร็จแล้วไปก่อนไม่ได้เหรอ คำตอบคือได้ แต่ทีละเครื่อง ห้ามพร้อมกัน
คลัสเตอร์สามเครื่องมี 3 vote ต้องมีอย่างน้อย 2 ถึงจะ quorate ถ้า A กับ C ลงพร้อมกัน จะเหลือ B ยืนอยู่เครื่องเดียว เท่ากับ 1 ใน 3 คลัสเตอร์ไม่ quorate และผลที่ตามมาทันทีคือ /etc/pve ซึ่งเป็นระบบไฟล์ของ pmxcfs จะกลายเป็นอ่านอย่างเดียว ปกติเรื่องนี้แค่ทำให้แก้ config ไม่ได้ชั่วคราว แต่คืนนั้น B กำลังอัปเกรดอยู่ postinst ของแพ็กเกจ Proxmox บางตัวที่ B กำลัง configure ต้องเขียนลง /etc/pve ถ้าเขียนไม่ได้ สคริปต์จะล้มกลางคัน ได้เครื่องที่แพ็กเกจติดตั้งไม่จบ ในจังหวะที่อีกสองเครื่องกำลังบูตอยู่
ลำดับที่ใช้จริงคือ reboot A ก่อน ระหว่างนั้นเหลือ B กับ C เป็น 2 ใน 3 รอจน A กลับมาและคลัสเตอร์ quorate ครบ ซึ่งได้ตอน 19:16:03 แล้วค่อย reboot C รอ C กลับมา จากนั้นรอให้ B ขึ้น DONE-OK แล้ว reboot B เป็นตัวสุดท้าย แต่ละเครื่องบูตกลับมาใช้เวลาตั้งแต่ราว 30 วินาทีถึงไม่กี่นาที
# ฝั่งเครื่อง admin: reboot หนึ่งเครื่อง แล้วรอจนเครื่องนั้นกลับมาเห็นคลัสเตอร์ quorate
reboot_one() {
  ssh root@"$1" 'systemctl reboot'
  sleep 60
  for i in $(seq 1 84); do                       # 60 + 84 x 10 วินาที = ไม่เกิน 15 นาที
    ssh -o ConnectTimeout=5 root@"$1" 'pvecm status | grep -q "Quorate:.*Yes"' && return 0
    sleep 10
  done
  echo "[ERR] $1 ไม่กลับมา quorate ภายใน 15 นาที"; return 1
}

reboot_one node-a || exit 1                      # เหลือ B + C = 2/3
reboot_one node-c || exit 1                      # เหลือ A + B = 2/3

# node-b เป็นตัวสุดท้าย และต้องอัปเกรดจบก่อนเท่านั้น
until ssh root@node-b 'grep -q DONE-OK /root/pve-upgrade.marker 2>/dev/null'; do sleep 30; done
reboot_one node-b
คลัสเตอร์ 3 node ที่เหลือ 1 node ไม่ quorate และ /etc/pve จะเขียนไม่ได้ ถ้าเครื่องที่เหลืออยู่กำลังรัน postinst ของแพ็กเกจ Proxmox การเขียนที่ล้มจะทำให้ dpkg พังกลางคัน ให้ reboot ทีละเครื่อง รอ Quorate: Yes ก่อนเครื่องถัดไปทุกครั้ง และให้เครื่องที่ยังอัปเกรดไม่จบเป็นตัวสุดท้ายเสมอ
ตรวจหลังบูต
พอครบสามเครื่องผมตรวจตามรายการเดิมทุกครั้ง ไม่เชื่อแค่ว่าเครื่อง ping ติด
pvecm status | grep -E 'Quorate|Total votes|Expected votes'      # Quorate: Yes, 3/3
pveversion                                                        # ตัวจัดการเป็นรุ่นย่อยล่าสุด
uname -r                                                          # kernel ตัวใหม่
systemctl is-active pve-cluster corosync pvedaemon pveproxy pvestatd pve-firewall
systemctl is-active tunnel-in.service; systemctl is-enabled tunnel-in.service
qm list; pct list                                                 # guest ที่ควรรัน กลับมาครบไหม
ผลคือตัวจัดการกับ kernel ขึ้นรุ่นย่อยล่าสุดครบทั้งสามเครื่อง pvecm status ขึ้น Quorate: Yes ครบ 3 ใน 3 บริการหลักทั้ง 6 ตัว active และ tunnel ขาเข้าที่ใช้ remote จากข้างนอก active กับ enabled ด้วยค่าเดิม ไม่ต้องตั้งใหม่ (ชื่อ unit ในตัวอย่างเป็นชื่อสมมติ ให้ใส่ชื่อบริการของตัวเอง)
- จดสถานะ guest ที่รันอยู่ ก่อนใครลงมือหยุดอะไร ไม่ใช่ให้สคริปต์จดตอนเริ่ม
- ตรวจ
/ให้เหลือเกิน 2 GB และ/bootเกิน 200 MB ไม่พอให้หยุด ไม่อัปเกรด - รันสคริปต์อัปเกรดแบบ detach พร้อมกันได้ทุก node จบด้วย marker
DONE-OKหรือDONE-FAIL - node ไหนช้า ให้ดู process ตัวนับ และขนาดไฟล์ วัดอัตราแล้วค่อยตัดสินว่าช้าหรือค้าง
- มี
DONE-FAILแม้เครื่องเดียว ไม่ reboot ทั้งชุด อ่าน log ก่อน - reboot ทีละเครื่อง รอ
Quorate: Yesทุกครั้ง เครื่องที่ยังอัปเกรดไม่จบเป็นตัวสุดท้าย - ตรวจ quorum รุ่น บริการหลัก tunnel และรายชื่อ guest เทียบกับที่จดไว้ในข้อแรก
ไฟล์รายชื่อ guest ว่าง 0 byte
บทเรียนสุดท้ายมาจากข้อแรกของสคริปต์เอง พอกลับมาเปิดไฟล์ /root/running-before-upgrade.txt เพื่อดูว่าก่อนอัปเกรดมีตัวไหนรันอยู่บ้าง ไฟล์ออกมา 0 byte ทั้งสามเครื่อง และใน log ไม่มีบรรทัด qm stop เลยสักบรรทัด
สคริปต์ไม่ได้ผิด เจ้าของหยุด VM ทั้งหมดด้วยมือไปก่อนที่สคริปต์จะเริ่ม ตอนที่สคริปต์มาถึงขั้นจดรายชื่อ ไม่มีอะไรรันอยู่ให้จดแล้ว มันเลยจดความว่างเปล่าลงไปอย่างถูกต้อง guest ที่กลับมารันเองหลัง reboot เลยมีแต่พวกที่ตั้ง onboot: 1 ไว้ ส่วน container ที่ตั้ง onboot: 0 ไม่กลับมาเอง ต้องมีคนจำได้ว่ามันเคยรันอยู่
# ดูว่า guest ตัวไหนจะกลับมาเองหลังบูต และตัวไหนต้องมีคนเปิด
grep -H '^onboot' /etc/pve/qemu-server/*.conf /etc/pve/lxc/*.conf 2>/dev/null
grep -L '^onboot: 1' /etc/pve/qemu-server/*.conf /etc/pve/lxc/*.conf 2>/dev/null
การจดสถานะไว้ในขั้นแรกของสคริปต์ถือว่าสคริปต์เป็นสิ่งแรกที่แตะระบบ ซึ่งไม่จริงในงานที่มีคนร่วมทำด้วย ไฟล์ 0 byte กับไฟล์ที่ไม่มีอยู่ให้ข้อมูลเท่ากัน คือไม่มีเลย ให้จดตั้งแต่ตอนรับงาน ก่อนประโยคว่าหยุด VM ทั้งหมดจะถูกลงมือทำ
สรุปคือคืนนั้นไม่มีอะไรพัง แต่มีสามจุดที่พังได้ถ้าตัดสินใจเร็วไปก้าวเดียว ฆ่า dpkg ของเครื่องที่แค่ช้า reboot สองเครื่องพร้อมกันเพราะมันเสร็จแล้ว และเชื่อไฟล์รายชื่อที่สคริปต์จดไว้โดยไม่เปิดดู ทั้งสามจุดแก้ด้วยวิธีเดียวกันคือวัดก่อนตัดสิน ดูตัวนับก่อนฆ่า ดู vote ก่อน reboot ดูขนาดไฟล์ก่อนเชื่อ ใครมีคลัสเตอร์สามเครื่องจะเอาลำดับนี้ไปปรับเวลา timeout ให้เข้ากับเครื่องตัวเองก็ตามสะดวกครับ ตรงไหนผมอธิบายตกหล่นหรือพิมพ์ผิด เดี๋ยวกลับมาแก้เพิ่มให้ภายหลังครับ
อยากให้เราทำให้ไหม?
ให้เราช่วยติดตั้ง ตั้งค่า ย้ายระบบ หรือแก้ปัญหาเซิร์ฟเวอร์ เพื่อให้คุณมีเวลาไปทำงานที่สำคัญกว่า
เคยเจองานแบบนี้ไหม? ติดตรงไหน?
มาแลกวิธีกันต่อในบอร์ด LinuxThai
ความคิดเห็น 0
ยังไม่มีความคิดเห็น — เป็นคนแรกเลย